
La réponse courte
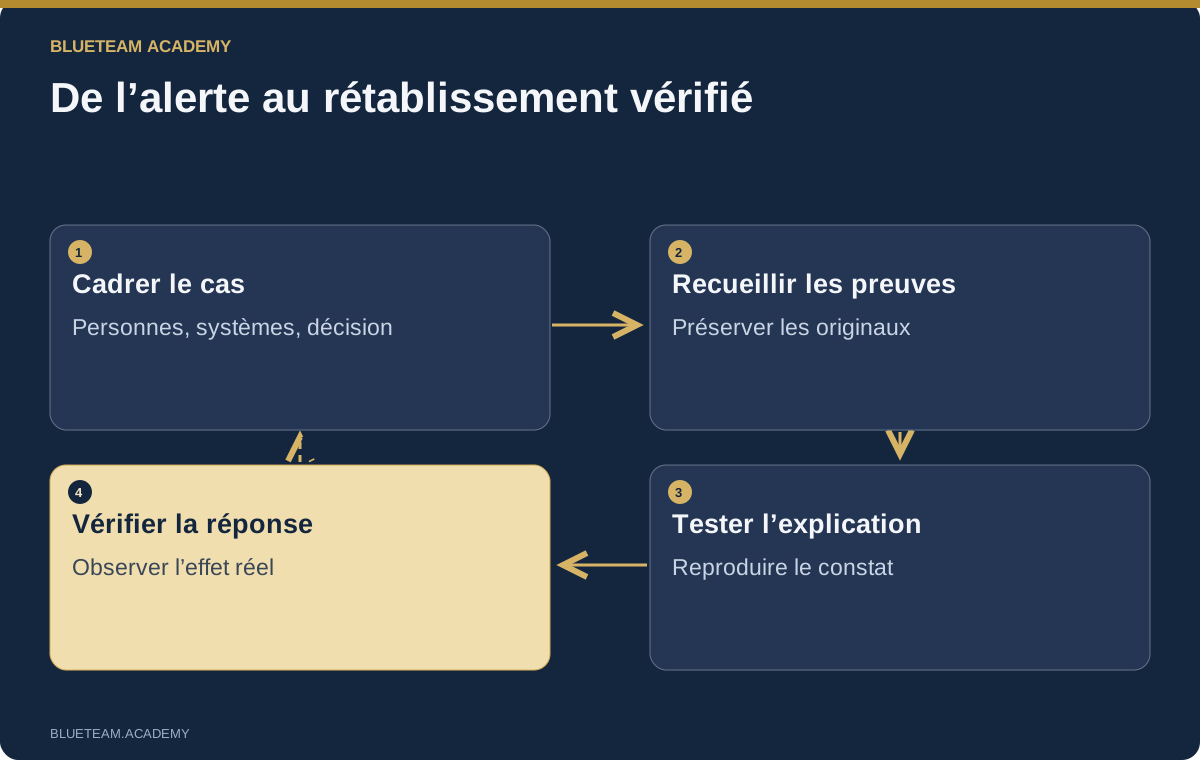
Une formation utile à la réponse aux incidents avec l’IA apprend à poser les bonnes questions, consulter les preuves originales, contester les conclusions du modèle et vérifier les mesures prises. Choisissez Claude, Codex/OpenAI OU un modèle local autorisé. Les trois ne sont pas nécessaires. Le critère reste le même : un autre analyste doit pouvoir reproduire le constat et expliquer pourquoi la réponse est justifiée.
Commencer par une situation et une décision concrètes
Lundi, 9 h 20. Au sein de l’entreprise fictive Riverton, une personne chargée des paiements fournisseurs reçoit une demande de changement de coordonnées bancaires. Le message figure dans une conversation familière. Quelques minutes plus tard, le fournisseur appelle pour contester cette demande. Une alerte de sécurité signale également une règle de messagerie inconnue. La comptabilité veut savoir s’il faut bloquer le paiement. L’équipe chargée des identités demande s’il faut désactiver le compte. Votre assistant n’a encore vu aucun de ces faits.
Une enquête commence ici : une personne, un service, un événement observé et une décision lourde de conséquences. « Analyse cette compromission » ne donne pas assez de contexte. « À partir de ces enregistrements, détermine si la demande de paiement contestée est liée à un accès non autorisé à la messagerie et indique les prochaines preuves nécessaires » délimite le travail. La formation à l’investigation et à la réponse aux incidents avec l’IA relie cette analyse aux exercices de confinement et de rétablissement.
Rédigez une courte présentation du cas avant d’accumuler les données. Indiquez le processus métier concerné, le compte observé, les systèmes, l’identifiant de l’alerte, la période et le risque immédiat. Précisez qui peut suspendre le paiement ou modifier les accès. Séparez soupçon et observation : une règle inconnue mérite une enquête, mais ne prouve pas la lecture de tous les messages par un attaquant.
Les exemples de cet article sont des situations pédagogiques fictives, et non des rapports complets d’incidents clients. Ils montrent comment raisonner à partir de preuves. La méthode reste utilisable avec différents assistants : l’outil organise l’enquête, tandis que les sources et les résultats observables déterminent ce que vous savez réellement.
Identifier le type d’incident avant de choisir les preuves
Une session volée, un point d’accès applicatif exposé, un serveur de fichiers chiffré et une chaîne de compilation compromise ne soulèvent pas les mêmes questions. « Cyberattaque » est une catégorie trop générale. Partez du résultat métier menacé. La confidentialité concerne les données devenues accessibles ou sorties de l’organisation. L’intégrité concerne les modifications non autorisées de données, paiements, logiciels ou configurations. La disponibilité concerne la capacité du service à remplir sa fonction. Une intrusion peut toucher les trois.
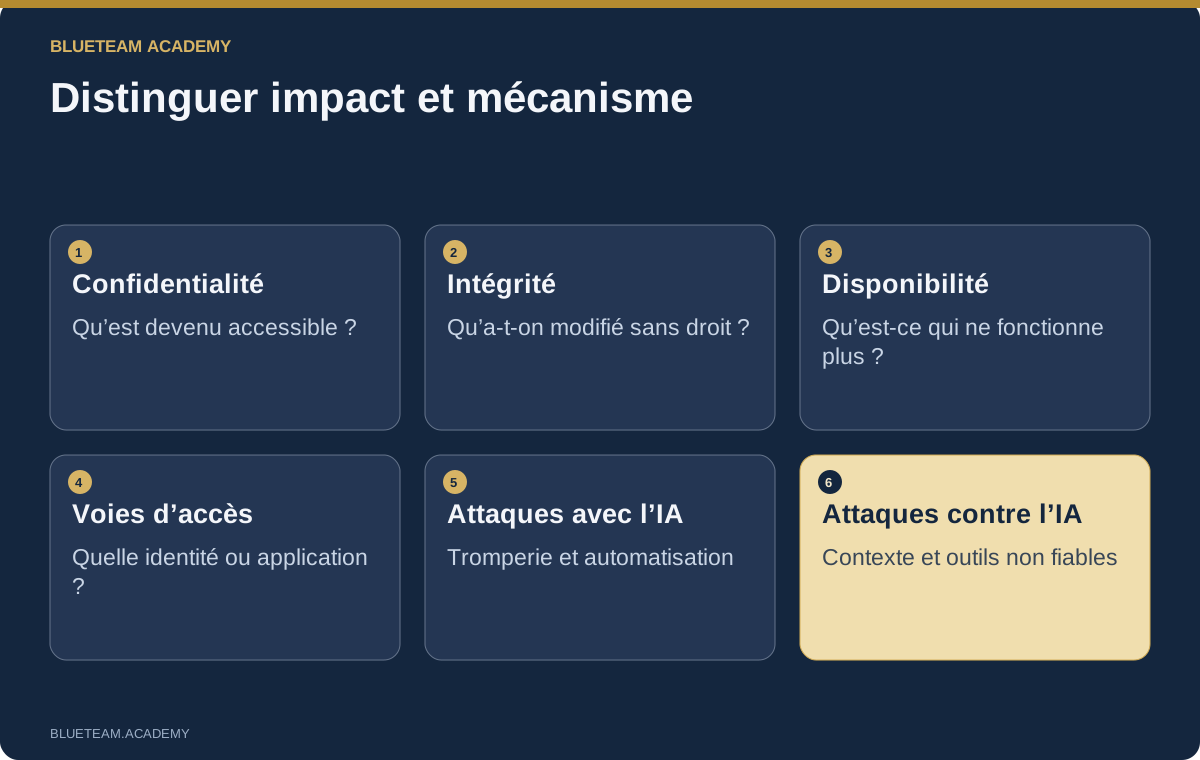
Examinez ensuite les mécanismes plausibles. Une fraude par courriel peut utiliser une adresse usurpée, la vraie boîte compromise d’un fournisseur ou la session volée d’un salarié. Une autorisation d’application peut survivre au changement de mot de passe. Un rançongiciel peut exfiltrer avant de chiffrer. Sur Linux, application web, compte de service et tâche planifiée peuvent être liés. Dans le cloud et les conteneurs, examinez les opérations d’administration, les identités des charges de travail et les ressources atteintes.
Distinguez les attaques assistées par l’IA des attaques visant les systèmes d’IA. Un attaquant peut rédiger des messages convaincants ou automatiser des tâches sans laisser de « signature IA » unique dans les journaux de la victime. À l’inverse, un agent applicatif peut subir des instructions provenant de documents non fiables, de contenus de recherche manipulés ou de permissions excessives. Enquêtez sur le comportement observable et la frontière de confiance défaillante. N’attribuez pas l’attaque à un modèle précis sans preuve.
Demandez un petit tableau d’hypothèses : type possible, observation favorable, autre explication, prochaine source décisive et mesure de protection immédiate. Une liste de toutes les techniques connues n’aide pas à décider. L’intérêt est de choisir la prochaine vérification et d’expliquer comment son résultat modifierait la réponse.
Claude, Codex/OpenAI ou modèle local : une seule voie suffit
La méthode ne doit pas imposer plusieurs abonnements. Claude, Codex/OpenAI et un modèle local ou hébergé par l’entreprise peuvent suivre le même processus : recevoir une question délimitée, examiner les données autorisées, proposer une étape et produire un résultat vérifiable. Leurs capacités et interfaces diffèrent ; le niveau d’exigence concernant les preuves reste identique.
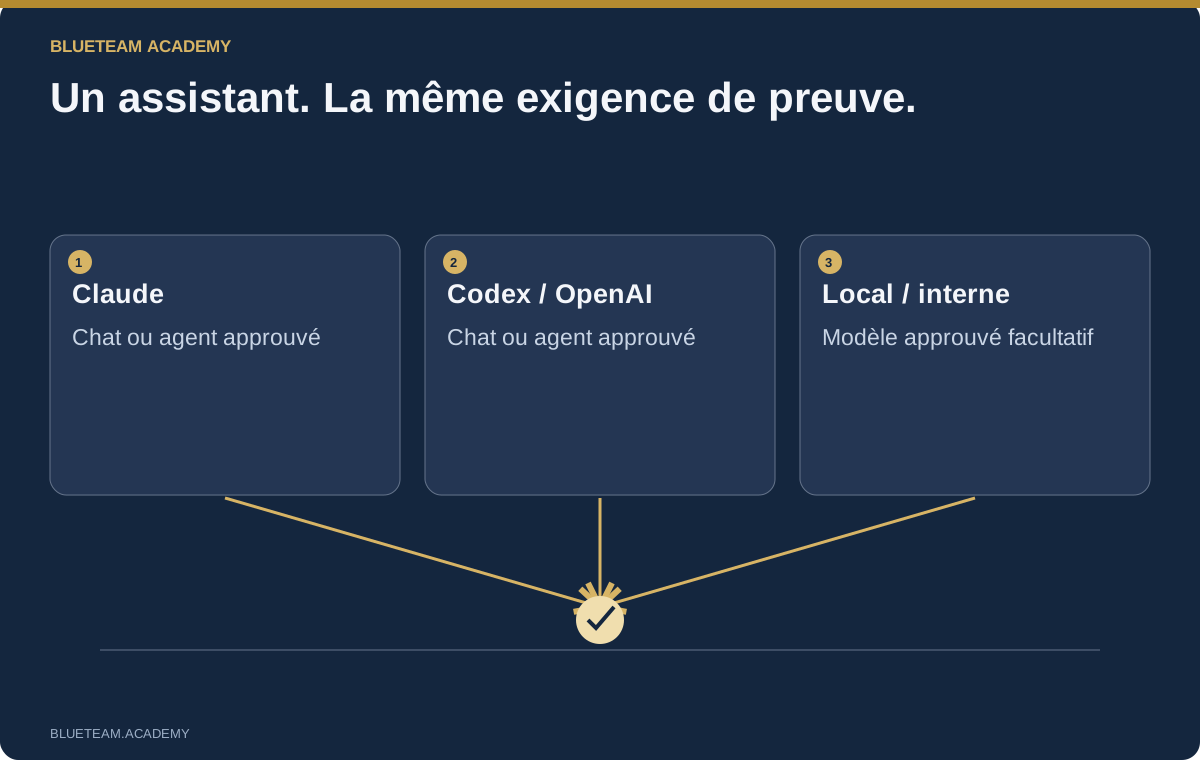
Un assistant dans le navigateur constitue un point de départ valable. Fournissez des données synthétiques choisies ou des extraits approuvés, demandez un plan de lecture, exécutez vous-même la requête proposée et transmettez le résultat réel. Un agent en ligne de commande peut consulter des fichiers et écrire des outils d’extraction, mais dispose aussi de droits d’exécution. Vérifiez permissions, services connectés et emplacements modifiables avant d’ouvrir le dossier. Consultez les consignes de sécurité de Codex ou la documentation des permissions de Claude Code. Écrire « lecture seule » dans une consigne ne crée pas une isolation au niveau du système d’exploitation.
Les modèles locaux sont une option. Un modèle tel que Qwen3-14B doit être évalué sur le travail réel : extraction de champs, interprétation des horodatages, preuves contradictoires et absence d’invention quand une information manque. Le nombre de paramètres ne démontre pas la qualité d’une enquête. Un service interne exige lui aussi authentification, séparation des dossiers, règles de conservation et tests de capacité. Une adresse réseau locale ne garantit pas que tout traitement reste local.
Choisissez la voie approuvée par votre organisation. Consignez fournisseur, identifiant du modèle, date, réglages pertinents et outils connectés. Ne transférez pas une affaire sensible à un autre service uniquement parce que la première réponse déçoit. Améliorez d’abord la question et testez le résultat avant de modifier le périmètre de traitement des données.
Préserver les originaux et la traçabilité du dossier
Séparez les preuves originales des documents de travail. Une arborescence utile distingue les informations de collecte, les originaux, les tableaux dérivés, les requêtes, les conversations avec le modèle et le journal des mesures. Un CSV convaincant produit par l’assistant reste un résultat de transformation, pas un remplacement de sa source. Conservez la requête et les règles de transformation avec lui.
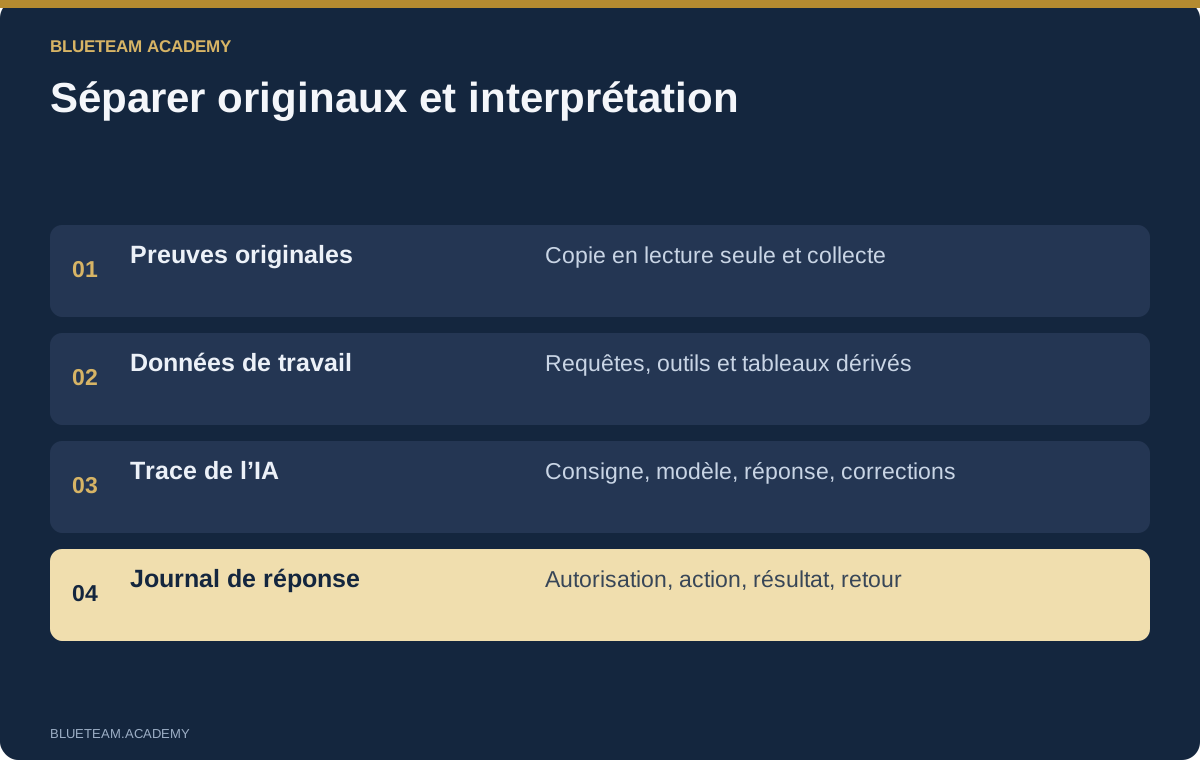
Tenez un registre simple des preuves : identifiant stable, système source, méthode et moment de collecte, période couverte, fuseau horaire, filtres et lacunes connues. Une empreinte permet de détecter une modification des octets. Elle ne prouve ni l’exhaustivité de la collecte ni la fiabilité du système source. Indiquez cette utilité et cette limite lorsque vous utilisez un hash pour appuyer un constat.
Limitez l’assistant à une copie de travail. Excluez les dossiers d’autres clients, identifiants de production, profils de navigateur et secrets de l’équipe de réponse. Les textes de journaux, documents et noms de fichiers sont des données non fiables : un attaquant peut y avoir placé des instructions. Le modèle peut les lire comme preuves, mais elles ne doivent pas définir ses droits ni autoriser l’usage d’un outil.
Donnez à chaque résultat un nom et une provenance clairs. Une chronologie de processus doit préciser fichier d’entrée, version de l’outil d’analyse, requête, hypothèse de fuseau et enregistrements exclus. Gardez la réponse initiale avant de la modifier. Sinon, le relecteur ne saura plus si une affirmation vient d’une source, de l’analyste ou du modèle. Des notes structurées permettent à un collègue de reprendre l’affaire sans reconstruire toute la conversation.
Adopter une boucle d’enquête reproductible
Demandez d’abord un plan, pas un verdict final. L’assistant doit proposer quelques contrôles en lecture seule, la source nécessaire et l’explication concurrente que chacun permet de tester. Un bon plan comporte des conditions d’arrêt. Une question précise ne nécessite pas tous les journaux du tenant, tous les postes et un accès illimité.
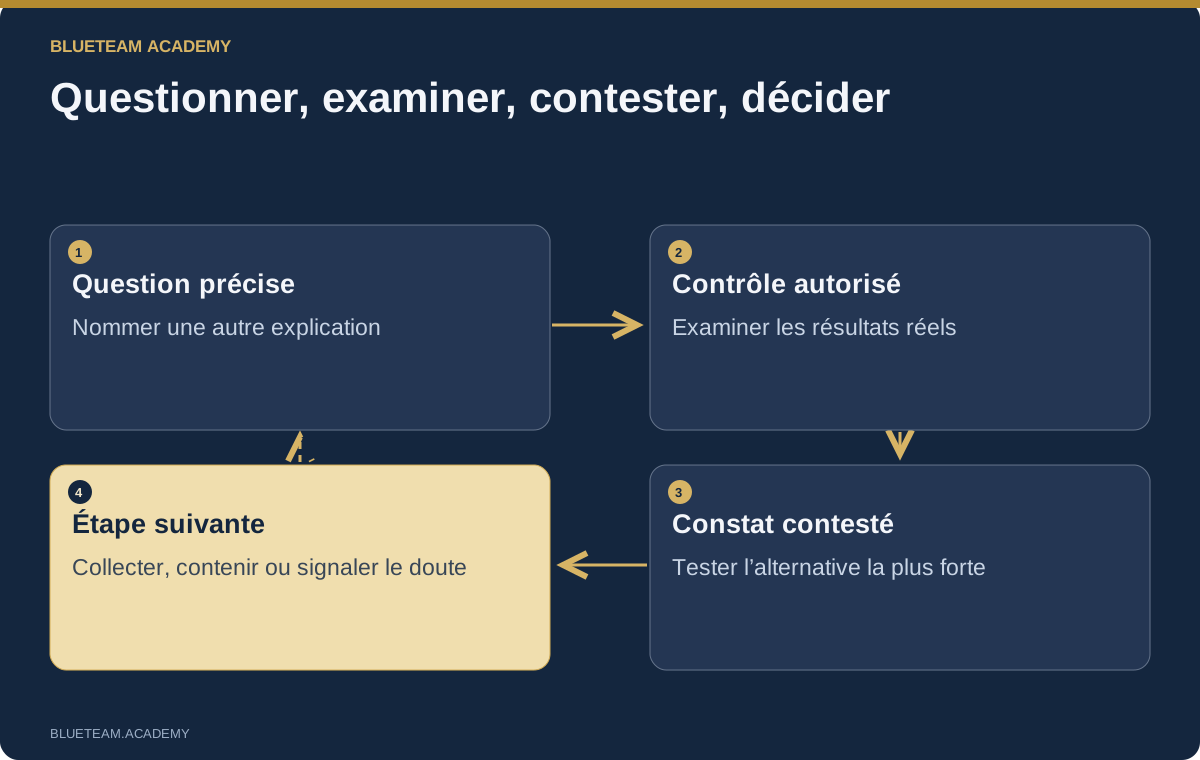
Analyse uniquement les enregistrements fournis pour ce cas. Propose d’abord six vérifications en lecture seule au maximum. Pour chacune, indique source, champs, période et explication concurrente. N’exécute aucune mesure de réponse et n’invente pas de données absentes. Après réception des résultats, sépare observations, déductions et inconnues. Appuie chaque affirmation importante sur un enregistrement et un champ précis. Termine par la question dont la réponse est la plus susceptible de changer notre réaction.
Relisez le plan, effectuez un contrôle autorisé et examinez sa sortie réelle. Vérifiez période, champ d’identité et jeu de données. Renvoyez ensuite ce résultat et demandez ce qu’il permet d’établir et ce qui reste incertain. Gardez requête et enregistrements, pas seulement le résumé du dialogue.
Le second passage doit mettre le premier à l’épreuve. Quelle explication bénigne reste possible ? Quels éléments contredisent l’hypothèse principale ? Quelle lacune de collecte pourrait inverser la conclusion ? Un second modèle peut aider, sans être obligatoire. Deux réponses fondées sur la même hypothèse non démontrée ne constituent pas une vérification indépendante. Reproduisez vous-même la jointure décisive.
Chaque boucle se termine par une décision : recueillir une autre source, prendre une mesure autorisée, réduire le périmètre ou signaler une incertitude précise. C’est ainsi que la rédaction de consignes devient un travail d’enquête. Sans décision, même une excellente mise en forme peut produire un document que personne n’utilise pendant l’incident.
Enquêter sur la fraude par courriel, les sessions et les applications
Revenons au paiement contesté de Riverton. Réunissez identifiants des messages, routage, résultats d’authentification, configuration de la règle, événements d’audit et version du fournisseur. SPF, DKIM ou DMARC réussis répondent à des questions d’authentification du courriel, pas à la légitimité de l’instruction métier. Le véritable compte de l’expéditeur peut être compromis, ou une conversation réelle détournée.
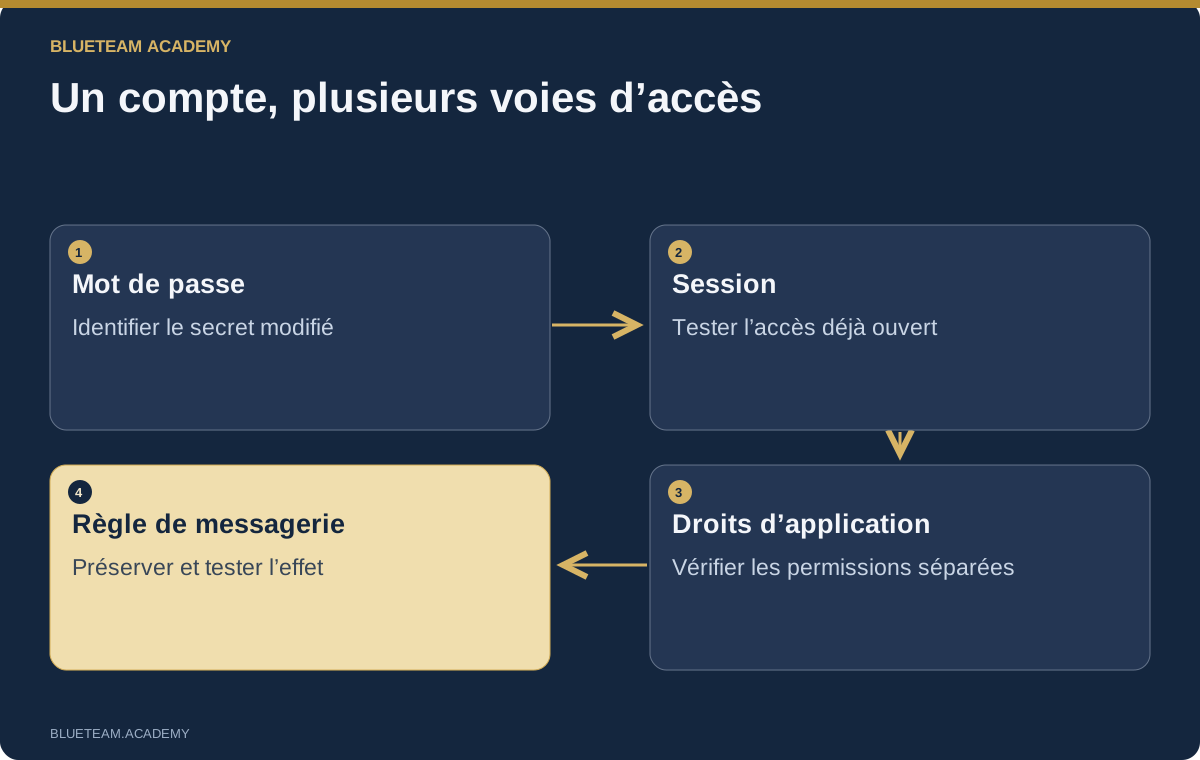
Demandez à l’assistant de relier l’opération sur la règle au compte, à l’application ou à la session concernés. Vérifiez quelle source identifie l’acteur et si elle représente une connexion humaine, une opération d’administration ou un accès applicatif. Comparez soigneusement les heures. Une IP partagée ou un appareil connu apporte du contexte sans identifier avec certitude la personne qui utilisait la session.
Séparez les voies d’accès avant d’agir. Changer un mot de passe, invalider des sessions, supprimer une règle de transfert et révoquer une autorisation d’application répondent à des mécanismes différents. Ne déclarez pas le compte sécurisé parce qu’une seule commande a réussi. Préservez les preuves, identifiez l’autorité d’approbation et vérifiez ensuite si la voie suspecte fonctionne encore. Dans une formation, l’échec d’une mesure doit se voir dans les résultats, pas seulement dans le corrigé.
Avec Microsoft 365, Google Workspace ou une autre plateforme, les questions fondamentales restent les mêmes : quelle identité a agi, par quelle session ou application, sur quelle ressource, avec quelle permission et quel effet ? Les interfaces changent, le raisonnement se transfère. Maintenez aussi le blocage du paiement et la vérification indépendante du fournisseur dans le plan. Une action technique réussie ne récupère pas les fonds et ne valide pas de nouvelles coordonnées bancaires.
Analyser un fichier suspect sans inventer son exécution
Un exécutable suspect fournit plusieurs catégories de preuves. L’analyse statique décrit structure, imports, sections, chaînes et signature. Les données du poste décrivent l’activité observée sur une machine précise. Une sandbox décrit une exécution dans ses propres conditions. Les services de réputation ajoutent des observations provenant d’ailleurs. Aucune de ces catégories ne doit remplacer discrètement une autre.
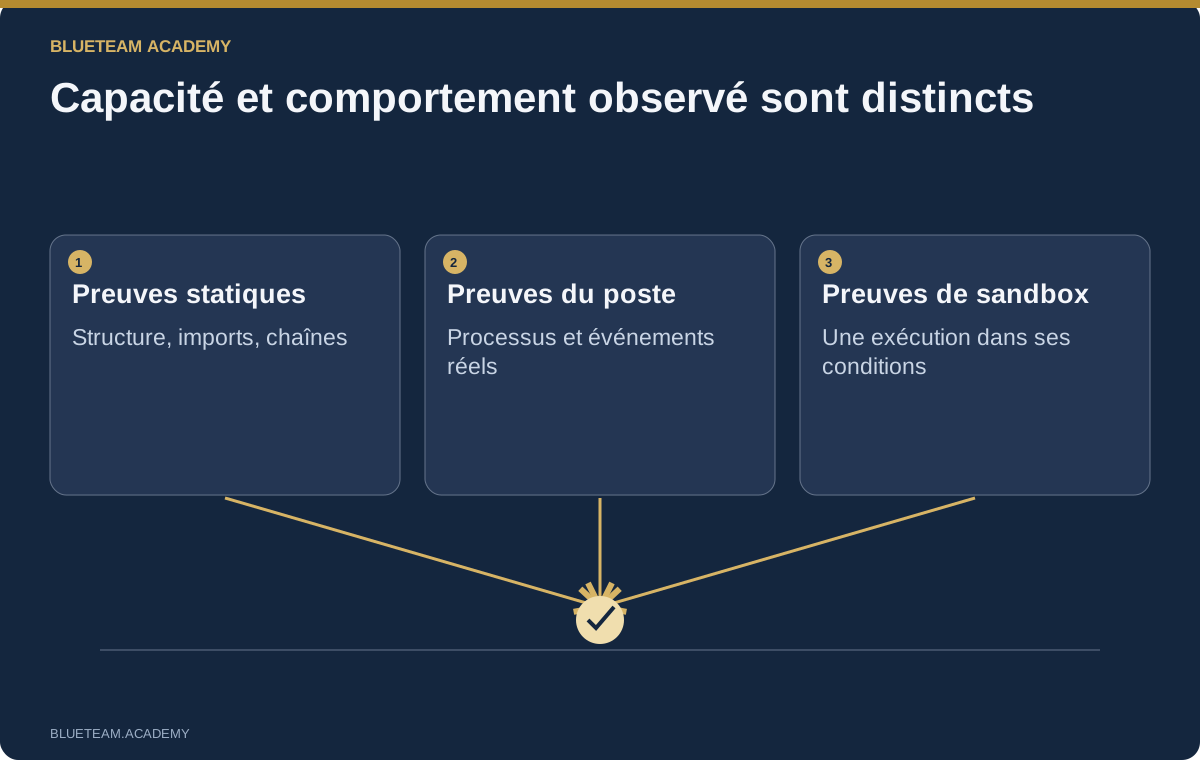
Supposons qu’un fichier importe une fonction réseau et qu’un journal montre un processus PowerShell enfant. Cela ne prouve ni vol d’identifiants, ni chiffrement de documents, ni connexion à tous les domaines présents dans ses chaînes. Demandez de distinguer capacités, comportement observé et hypothèses. Toute affirmation d’exécution doit préciser la relation entre processus et la source. Une ligne de commande absente reste absente, sans être complétée par un exemple d’attaque connu.
Utilisez des outils approuvés pour produire des sorties limitées que l’assistant peut expliquer. PEStudio, un outil d’identification des capacités ou un désassembleur répondent à des questions différentes. Gardez sortie originale et version. Si le modèle propose de décoder une chaîne, vérifiez l’opération et conservez le résultat comme donnée. N’exécutez pas les commandes extraites simplement pour observer leur effet.
Les exercices peuvent employer des artefacts inertes, des synthèses de sandbox préparées et des preuves publiques sélectionnées avec une provenance claire. Une tâche utile demande de calculer l’empreinte réelle de l’échantillon, de la distinguer d’un identifiant illustratif et de préciser les preuves supplémentaires nécessaires. Les règles de détection doivent aussi être testées : une règle YARA visant un nom d’API courant peut produire beaucoup de faux positifs. Demandez des échantillons positifs et bénins et examinez les résultats avant tout usage opérationnel.
Corréler correctement journaux, MFT et identités de processus
L’IA peut expliquer un schéma de journal, proposer un parseur ou repérer une séquence candidate. Elle ne peut pas compenser l’absence de contexte dans des exports non documentés. Commencez par le format et la couverture de collecte. Un tableau normalisé est plus lisible mais peut omettre un champ indispensable pour distinguer deux événements. Préservez le retour aux originaux.
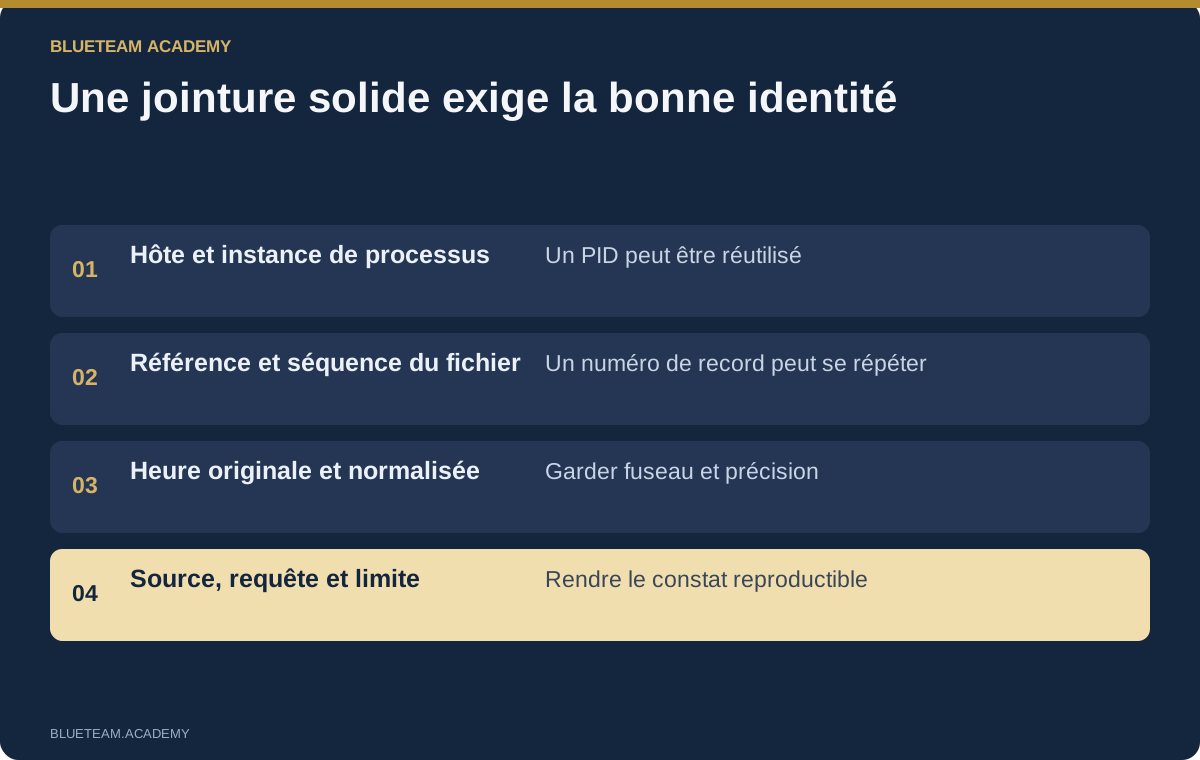
Sous Windows, distinguez PID et identifiant durable de l’instance de processus. Incluez hôte et période dans les jointures : un PID peut être réutilisé. Une relation parent-enfant requiert les bons champs ; noms similaires et horaires proches ne suffisent pas. Pour le système de fichiers, comprenez référence d’enregistrement et numéro de séquence avant de fusionner des correspondances. Une entrée MFT réutilisée ne désigne pas automatiquement le même fichier.
Vérifiez les horodatages séparément. Heure de l’événement, de collecte, du système de fichiers et heure locale affichée peuvent répondre à des questions distinctes. Faites préciser la valeur utilisée, les décalages de fuseau, la précision et les écarts d’horloge. Conservez valeur originale et normalisée côte à côte. N’ordonnez pas les événements plus finement que les données ne l’autorisent.
Donnez un objectif précis : trouver les candidats, montrer les clés de jointure, lister les lignes sans correspondance et expliquer un contre-exemple. Testez la requête sur un cas positif connu et une valeur volontairement absente. Zéro résultat signifie seulement que rien n’a été trouvé dans les données collectées. Cela ne prouve pas l’absence d’un événement sur un poste non surveillé. Une enquête gagne en solidité quand ses limites restent visibles.
Tester une hypothèse d’exfiltration avec les données réseau
Une connexion sortante est une piste, pas une preuve complète d’exfiltration. Établissez source, destination, protocole, horaires, processus si disponible et point d’observation. Un journal de pare-feu, un proxy et une capture réseau décrivent parfois des aspects différents de la même activité. Expliquez ce que mesure chaque source avant d’additionner les chiffres.
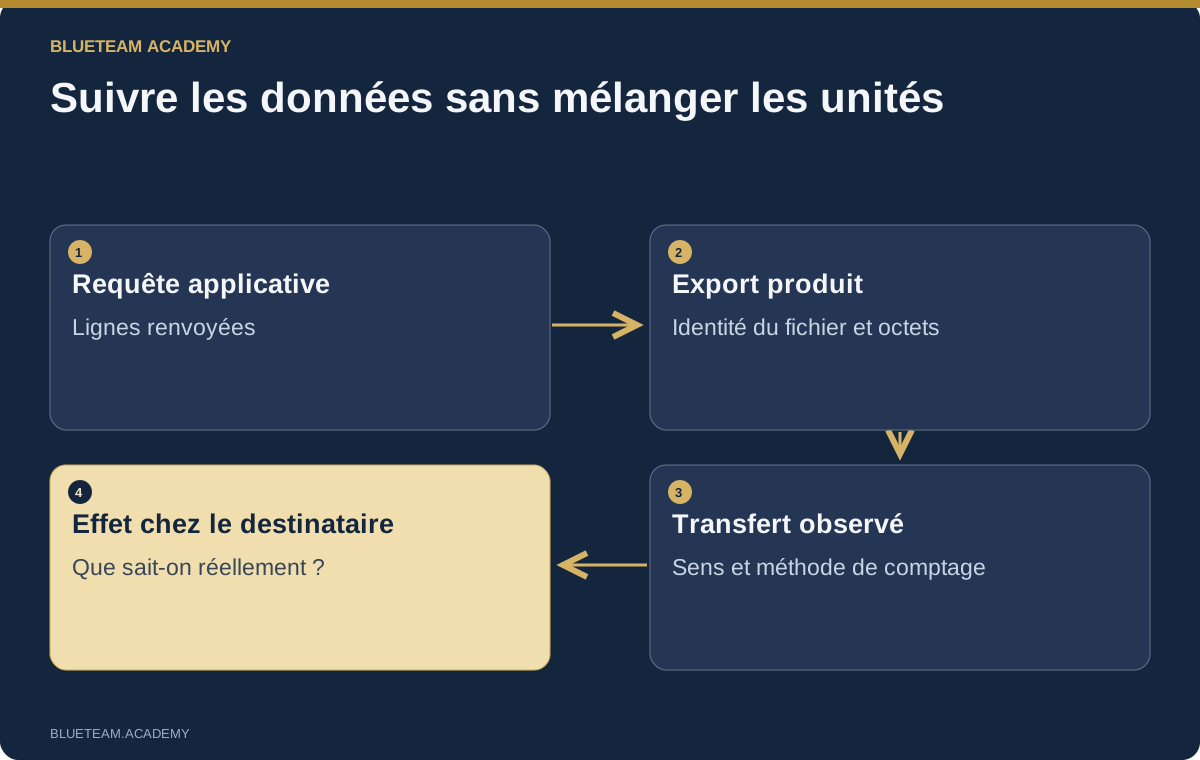
Les volumes sont un piège fréquent. Une capture peut compter des retransmissions, alors qu’un proxy compte au niveau applicatif. TLS peut masquer le contenu même si les métadonnées restent visibles. La taille d’une réponse n’est pas un nombre de fiches clients uniques. Faites préciser unité, sens, source et méthode d’agrégation de chaque quantité.
Pour mieux étayer une fuite, reliez requête applicative, export généré, identifiant ou empreinte du fichier, preuve de livraison et observation réseau. Si une alerte cite le hash d’une archive, confirmez qu’il s’agit du même artefact, pas d’un nom ressemblant. Distinguez les maillons établis des hypothèses. Une demande d’envoi ne prouve pas toujours que le destinataire a conservé ou lu les données.
Une consigne utile : « Montre le chemin étayé entre les données sources et le transfert sortant. Pour chaque lien, cite un enregistrement original et le test manquant. » Puis demandez quelle autre explication convient au même trafic. Bloquer une destination, suspendre un export ou modifier l’accès exige un responsable et un contrôle d’effet. Bloquer une IP partagée peut interrompre des échanges légitimes tout en laissant une autre voie de sortie ouverte.
Relier ATT&CK aux faits, pas à la décoration du rapport
MITRE ATT&CK fournit un vocabulaire commun des comportements adverses. Utilisez-le pour organiser les observations, choisir les sources manquantes et communiquer le périmètre. Un libellé d’alerte ne devient pas pour autant une chaîne de techniques confirmée. Le modèle doit expliquer le comportement correspondant à chaque proposition et citer la preuve.
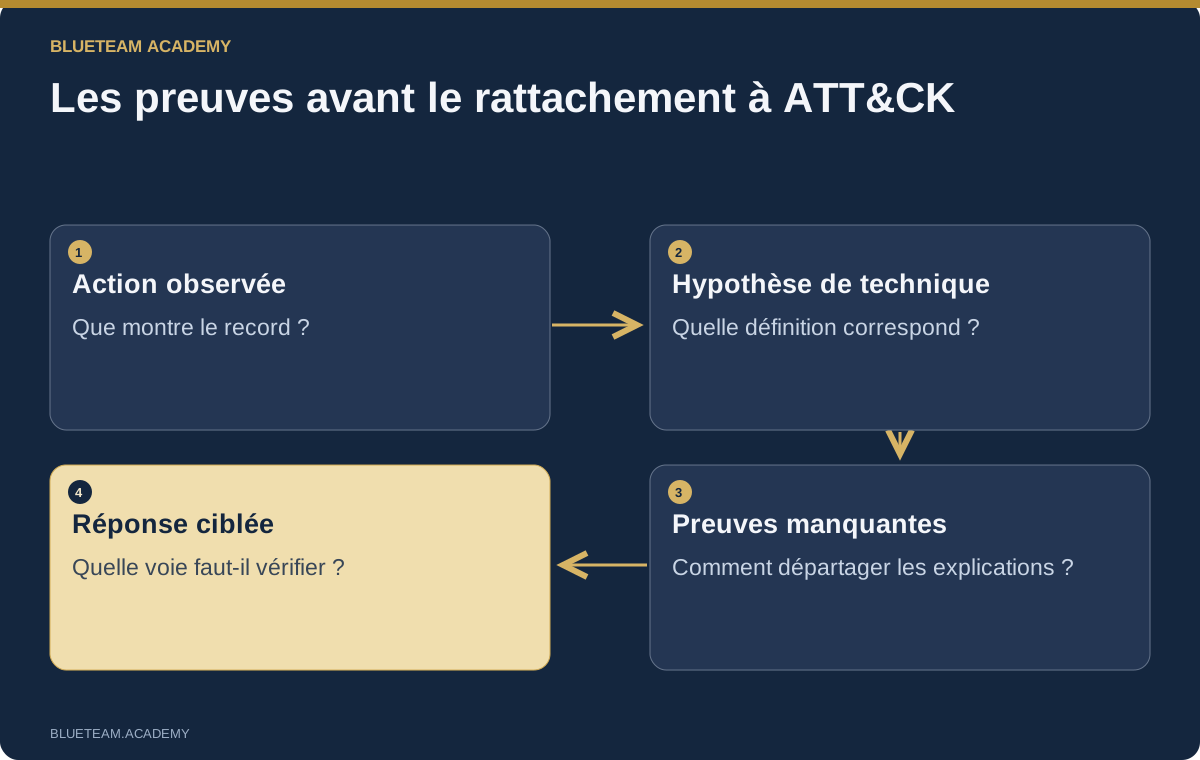
Une connexion réseau, un contrôle d’accès autorisé à un partage administratif, un nouveau service et un processus lancé par le gestionnaire de services peuvent étayer une enquête sur un déplacement latéral. Ils ne prouvent pas à eux seuls l’extraction d’identifiants ni leur mode d’obtention. Demandez technique, comportement, sources, confiance et prochain test. Les possibilités non démontrées restent des hypothèses.
Consultez les définitions actuelles d’Enterprise ATT&CK. Le cadre et les noms évoluent. Pour les systèmes d’IA, des entrées comme Indirect Prompt Injection apportent un contexte, avec MITRE ATLAS. Un identifiant mémorisé par le modèle n’est pas une référence faisant autorité.
Le bénéfice pratique est un meilleur plan de collecte et de réponse. Si l’hypothèse est l’exécution distante d’un service, recherchez les données permettant de la distinguer d’une administration approuvée. Si elle concerne une application, examinez l’autorisation et les opérations sur les ressources. Le schéma de couverture doit révéler questions et lacunes. Colorier plus de cases ne rend pas le dossier plus complet et n’explique pas l’impact métier.
Examiner Linux et les défaillances d’autorisation des API
Un incident web traverse plusieurs couches : reverse proxy, application, système d’exploitation et réseau. Corrélez identifiants de requête, relations des workers, chemins et ascendance des processus quand ces données existent. Un shell peu après un téléversement mérite une enquête, mais la proximité horaire ne prouve pas le lien requête-processus.
Examinez ensemble les preuves applicatives et système. Un type de fichier interdit a-t-il été accepté ? Le fichier a-t-il été placé dans un emplacement exécutable ? Quelle identité utilisait le worker ? Trouve-t-on des tâches planifiées, modifications de services ou connexions associées ? Regroupez les enregistrements Linux audit fragmentés par identifiant d’événement commun et conservez les champs pertinents. Un fichier appartenant à root n’identifie pas son auteur humain.
Un incident API peut exiger une réponse différente d’une compromission d’hôte. Un utilisateur valide peut demander l’objet d’une autre entreprise si le serveur ne contrôle pas sa propriété. Comparez identité authentifiée, tenant déterminé côté serveur, objet demandé et décision d’autorisation. Une valeur de tenant fournie par le client ou le modèle ne constitue pas une autorité fiable.
Utilisez l’IA pour repérer les routes voisines et proposer des tests négatifs : exports, traitements différés, téléchargements, caches et opérations en masse. Relisez le chemin de code et exécutez des tests représentatifs dans un environnement autorisé. Une fonction corrigée ne démontre pas la correction de tous les parcours. Estimez l’exposition passée avec les traces conservées et indiquez les lacunes. Le rétablissement exige une frontière corrigée et des accès légitimes toujours fonctionnels.
Suivre les identités et les contrôleurs dans le cloud
Distinguez les actions de gestion de l’accès aux données. Une modification de permission, création de clé ou désactivation de journal explique parfois comment un accès est devenu possible. Pour établir ce qui a été lu ou changé, il faut des événements de ressource, lorsqu’ils existent. Vérifiez la configuration de collecte avant d’interpréter un export vide. La documentation des événements de données CloudTrail illustre cette nécessité.
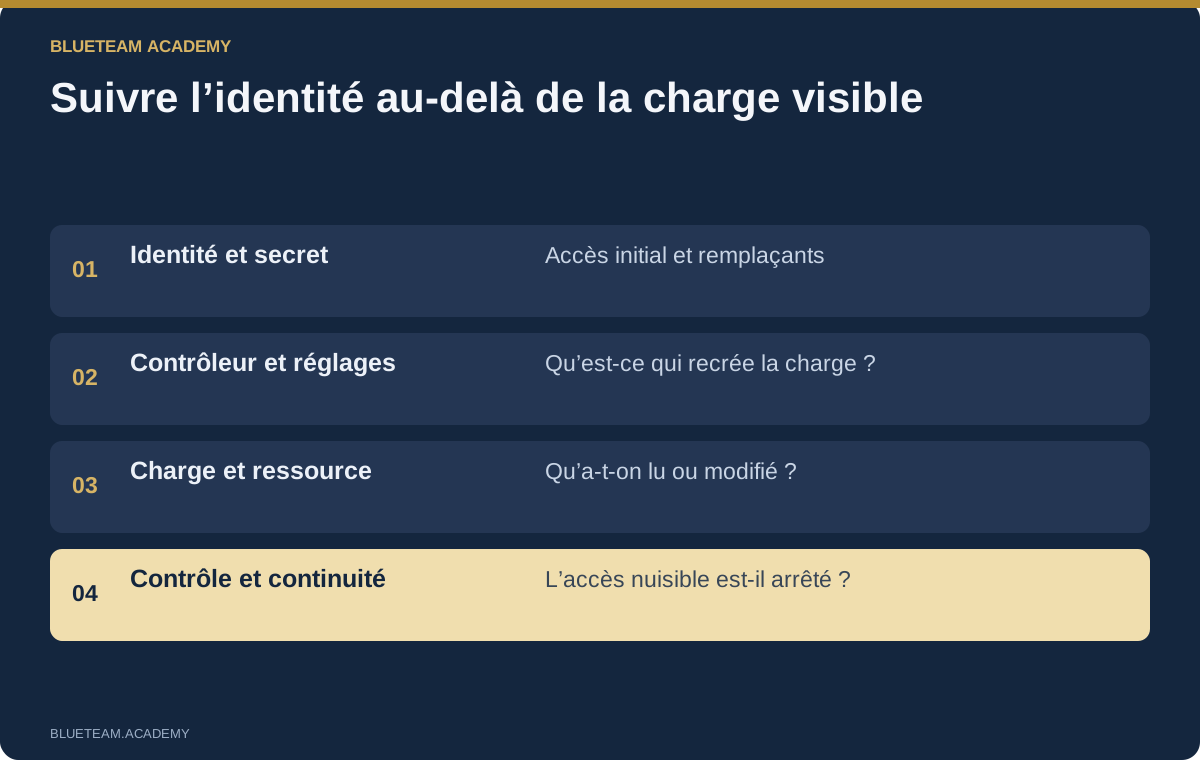
Raisonnez en voies d’accès. Si une clé exposée en crée une autre, désactiver seulement la première peut laisser un accès actif. Demandez un graphe des identités, secrets, autorisations, opérations et modifications ultérieures. Chaque lien doit être prouvé ou signalé comme hypothèse. Gardez identifiants, dates d’émission et ressources pour distinguer opération exécutée et tentative refusée.
Pour les conteneurs, incluez contrôleur et contexte du nœud. Supprimer un pod suspect peut simplement déclencher sa recréation. Examinez compte de service, décision d’admission, digest de l’image, contexte de sécurité, montages de l’hôte et observations du nœud. Une requête réussie de liste des secrets s’interprète selon les détails enregistrés : le journal d’audit peut ne pas contenir leurs valeurs.
Le plan de confinement doit couvrir identité, contrôleur, charge de travail et secrets exposés. Les actions destructrices restent hors du périmètre de l’outil d’analyse. Testez en préproduction ou dans un processus approuvé si la charge réapparaît et si les fonctions légitimes subsistent. L’IA hébergée en interne subit les mêmes risques d’infrastructure. Sa localisation ne dispense pas d’examiner identités et configuration.
Distinguer rançongiciel et panne de service
Chiffrement et destruction imposent des décisions rapides, mais l’urgence ne rend pas chaque symptôme diagnostique. Identifiez les systèmes modifiés anormalement, processus ou identité impliqués, poursuite des changements et services métier dépendants. Préservez les traces volatiles lorsque cela ne prolonge pas des dommages évitables. Le responsable de l’incident doit expliciter cet arbitrage.
Comparez l’activité suspecte à la maintenance autorisée. Un compte de déploiement peut être légitime alors que son utilisation sur un serveur sans rapport ne l’est pas. Un tableau de sauvegarde vert ne prouve pas une restauration réussie. Le succès d’une commande ne prouve pas l’atteinte de l’objectif métier. Prévoyez un test qui mesure le service réellement rétabli.
Des versions défectueuses, pools de connexions saturés et erreurs de configuration causent aussi des indisponibilités. Un fort trafic peut être une attaque, une hausse normale ou une conséquence. Comparez métriques, changements, erreurs applicatives et données réseau. Si un retour arrière rétablit le service, documentez ce fait sans déclarer automatiquement toute intention malveillante exclue.
Le plan comporte confinement, continuité, conservation des preuves, source de restauration fiable, tests d’acceptation et seuil de retour arrière. Que faire si la première restauration échoue ou si la reconnexion expose la même faiblesse ? Un bon exercice fait traiter ce résultat. « Des sauvegardes existent » décrit la préparation ; « la restauration testée satisfait ces critères de sécurité et de service » constitue un constat vérifié.
Enquêter sur la chaîne logicielle et les attaques contre l’IA
L’enquête sur la chaîne d’approvisionnement relie provenance du logiciel et exposition des identifiants. Comparez source approuvée, résolution des dépendances, environnement de build, artefact et digest déployé. Un tag familier ou une signature valide ne prouve pas à lui seul que le code attendu est présent. Demandez ce que lie réellement la signature ou l’attestation, qui contrôlait l’identité et si les entrées correspondent à la livraison.
Fournissez modifications de lockfile, journaux de compilation et inventaires pour une comparaison délimitée. Ne relancez pas un build inconnu sur un poste privilégié simplement pour reproduire le cas. Identifiez les secrets disponibles pour le runner et les opérations effectuées avec eux. Suivez l’artefact par digest jusqu’au déploiement et à la distribution. Une reconstruction saine peut donner une empreinte différente : la reproductibilité dépend du procédé.
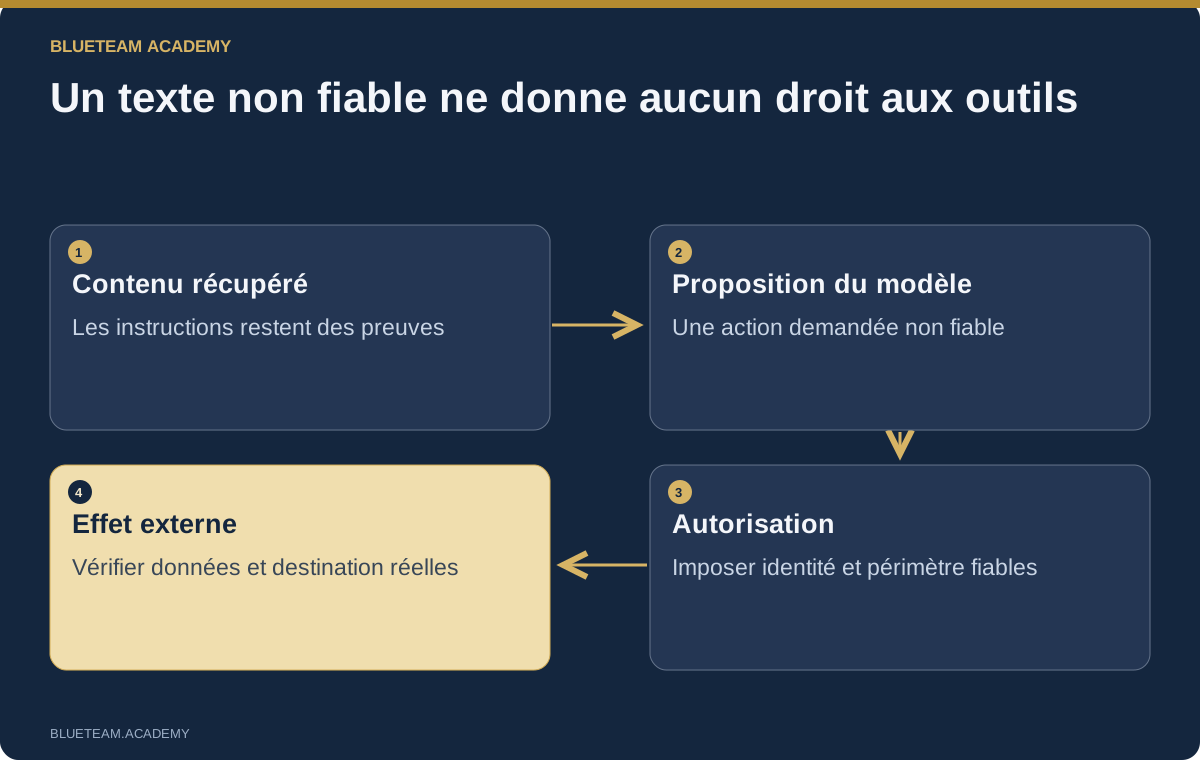
Un incident d’application IA ajoute une chaîne : entrée non fiable, proposition du modèle, autorisation d’outil et effet externe. Une instruction malveillante dans un ticket récupéré peut influencer le modèle sans modifier l’identité de confiance. Vérifiez que le composant exécutant les outils impose cette identité indépendamment. Distinguez une lecture interentreprises refusée d’une action sortante autorisée.
Analysez le contenu suspect dans un contexte séparé, sans les outils privilégiés initiaux. Examinez provenance de récupération, arguments, journaux d’autorisation, restrictions de destination et données réellement renvoyées ou transmises. Testez un cas négatif : le texte reste visible comme donnée, mais ne peut autoriser lecture étrangère ou transfert. Corrigez la frontière défaillante et vérifiez-la. Dire au modèle d’ignorer les mauvaises instructions ne démontre pas la sécurité de l’application.
Connecter VirusTotal sans publier les données de l’incident
La réputation aide à prioriser, sans trancher l’ensemble du cas. Partez d’une empreinte connue et d’une politique de divulgation approuvée. Une recherche exacte par hash demande un rapport existant, contrairement à l’envoi du fichier. Elle révèle néanmoins à un tiers ce que vous recherchez. Elle n’est ni invisible ni automatiquement acceptable.
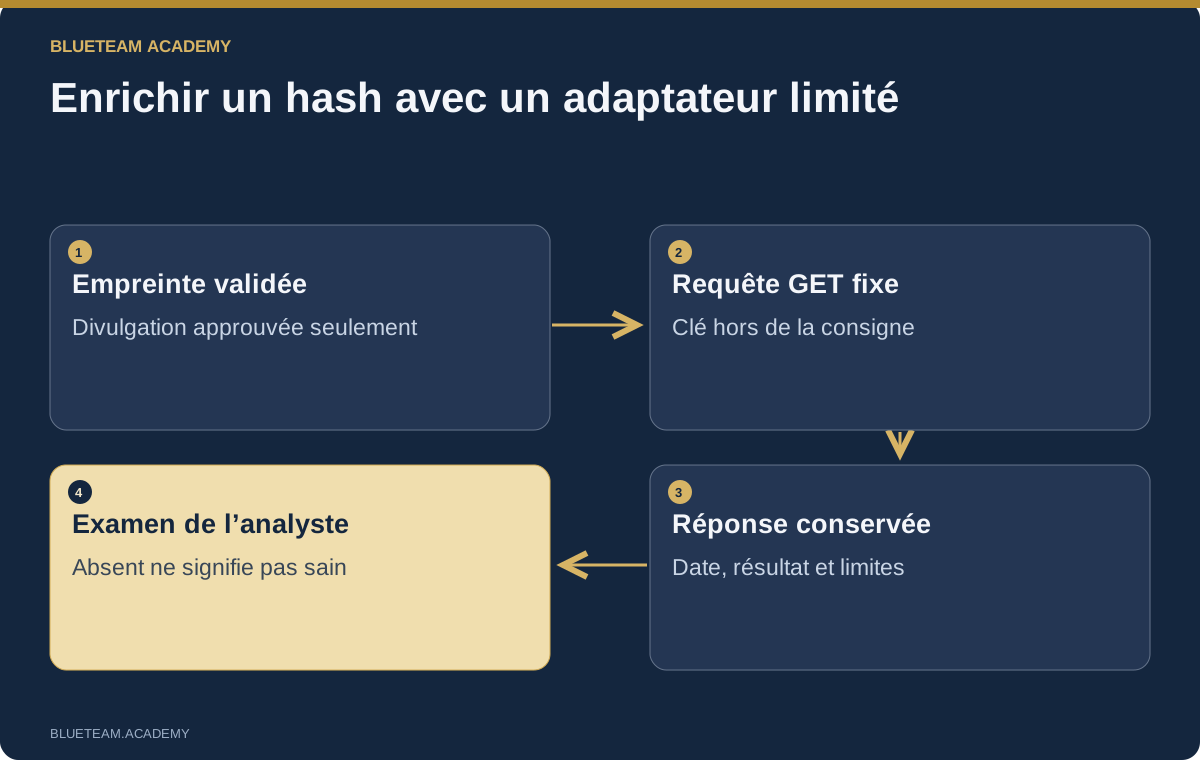
Le point d’accès de VirusTotal pour les rapports de fichiers récupère des informations par identifiant. Un adaptateur limité peut n’accepter qu’un SHA-256 valide, utiliser une destination fixe, lire sa clé dans une variable d’environnement protégée, refuser les redirections et imposer un délai. Le texte d’une preuve ne doit pas fournir l’URL, et la clé ne doit pas figurer dans le prompt. Vérifiez les droits d’usage commercial selon les conditions de l’API VirusTotal.
Faites interpréter une réponse sauvegardée avec heure de collecte, date du rapport et résultats utiles. Un rapport absent n’est pas un verdict d’innocuité. Une limite de débit doit arrêter ou différer la requête, pas provoquer une rotation de clés ou des essais infinis. Les détections sont des observations à apprécier. Leur proportion parmi les moteurs ne constitue pas une probabilité calibrée de malveillance.
Ne téléversez pas documents confidentiels, images mémoire, exports de messagerie ou fichiers clients dans un circuit public « pour voir ». Ils peuvent contenir données personnelles, secrets et informations propriétaires. Si nécessaire, utilisez une analyse privée autorisée. Une formation peut enseigner l’intégration avec des réponses enregistrées pour succès, absence et limitation, puis proposer une vraie recherche optionnelle avec un compte autorisé.
Faire préparer la réponse, puis vérifier son effet
Une enquête achevée par un beau rapport peut laisser l’accès nuisible actif. Chaque constat important doit conduire à des questions d’action : que changer, qui peut autoriser, quelles preuves préserver, quelle fonction métier risque d’être affectée et comment vérifier le succès ? L’assistant aide à structurer la décision ; il n’en devient pas l’autorité.
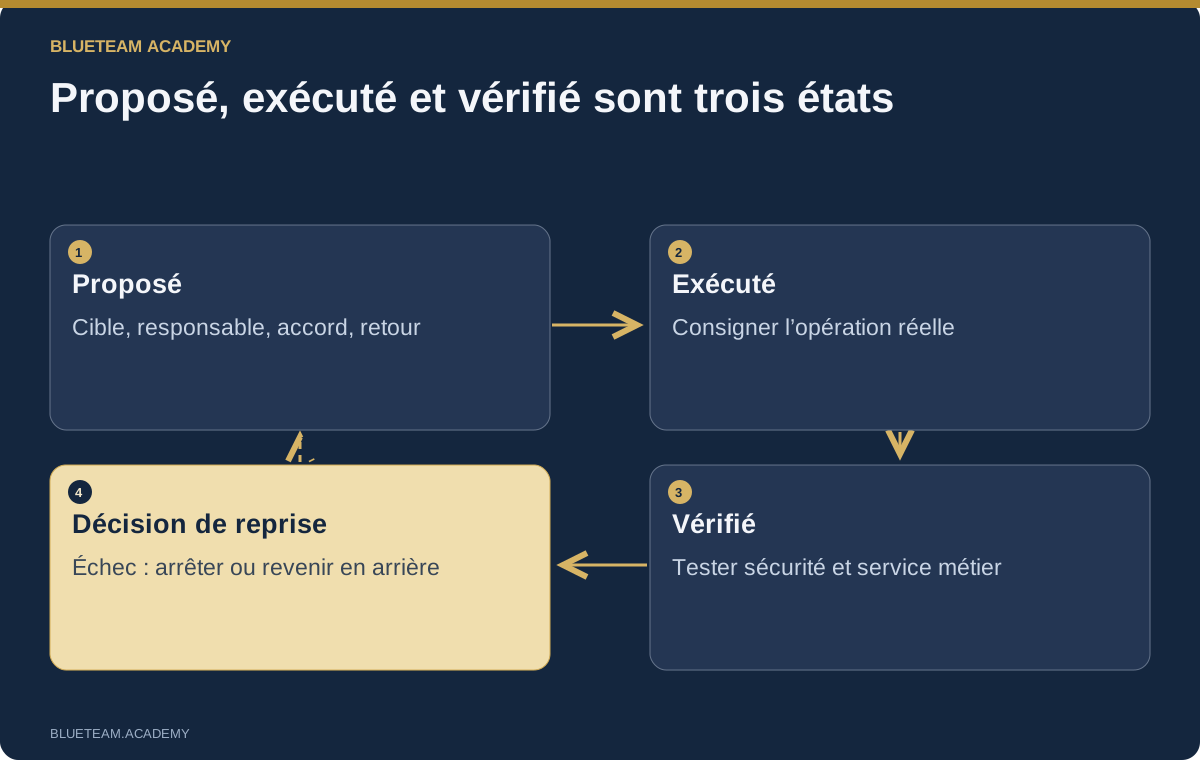
Séparez proposé, exécuté et vérifié. « Désactiver la clé » est une proposition. Un événement d’audit de désactivation prouve l’exécution. Un test contrôlé refusant l’ancienne clé, complété par la recherche de clés de remplacement, contribue à la vérification. Ne fusionnez pas ces états dans une seule case verte. Cette distinction vaut pour règles de messagerie, autorisations, isolation et retour de version.
Le journal de réponse contient identifiant d’action, cible, fondement, responsable, approbateur, effet attendu, preuve d’exécution, résultat du contrôle et condition de retour arrière. Ajoutez horaires et dépendances. Si isoler un serveur interrompt un paiement critique, documentez le mode de continuité et le décideur. Si attendre aggrave le dommage, expliquez l’autorisation urgente et les traces susceptibles d’être perdues.
Le rétablissement exige des critères indépendants. Testez l’ancien accès interdit, la persistance et les accès alternatifs, le contrôle corrigé et le service métier. Définissez une reprise limitée et une condition d’arrêt ou d’annulation. Un test échoué appelle un refus de remise en service, pas un rapport réécrit avec davantage d’assurance.
Le NIST SP 800-61 Rev. 3 inscrit la réponse dans la gestion globale du risque cyber. Transformez les enseignements en améliorations attribuées : journaux manquants, responsabilités floues, tests faibles et permissions excessives des agents. Le dossier n’est pas clos simplement parce que l’alerte visible s’est arrêtée.
Relire les preuves et le raisonnement, pas seulement le style
Adaptez les sorties aux lecteurs. La relève technique a besoin d’identifiants, requêtes, relations entre sources, incertitudes, actions et contrôles restants. La direction attend effets métier, éléments maîtrisés, incertitudes, décision nécessaire et prochain point. Les deux doivent décrire le même état. Une synthèse courte ne doit pas être plus affirmative que son dossier technique.
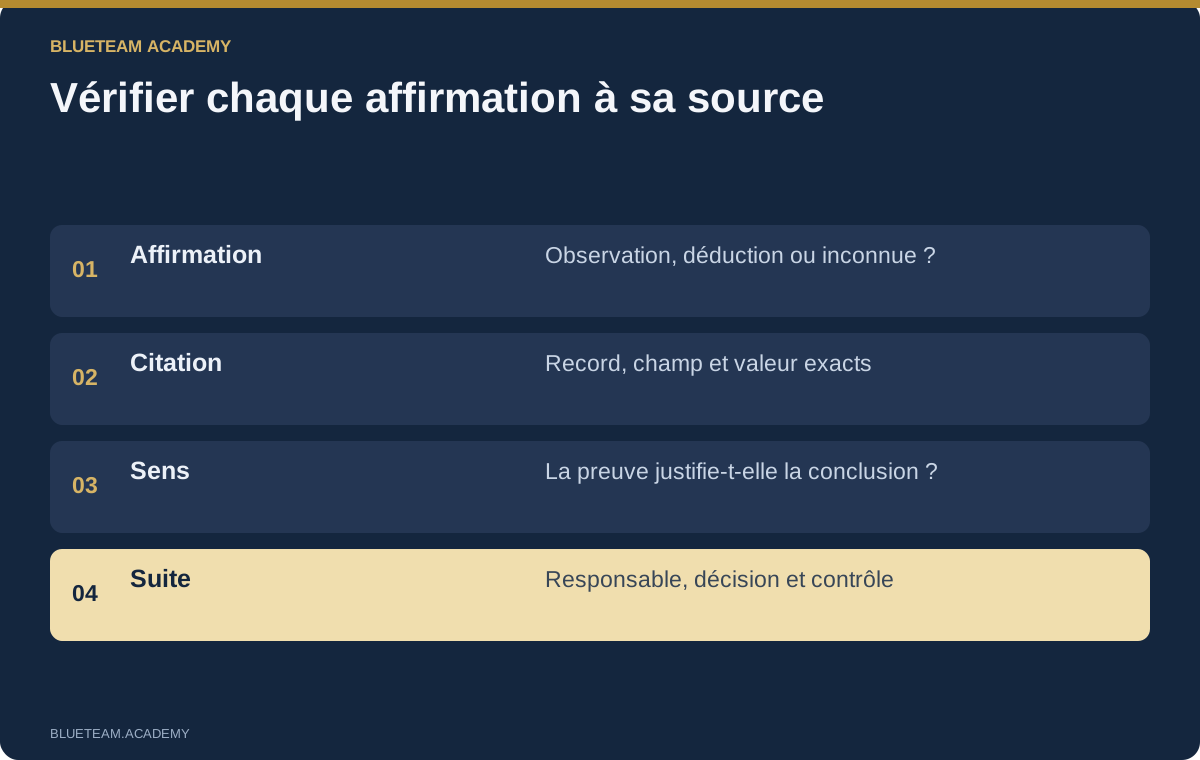
Confrontez chaque phrase importante à ses preuves. Peut-on ouvrir le document cité ? Le champ contient-il la valeur annoncée ? Cette valeur justifie-t-elle l’interprétation ? La source appartient-elle à un autre cas ? Une proposition devient-elle une action terminée ? « Aucun événement dans cet export » devient-il « aucune compromission » ? Ce sont des contrôles de fond, pas de grammaire.
Tenez un registre des affirmations : observation ou déduction, source, champ exact, limite et prochaine vérification. Un validateur peut rejeter identifiants absents ou valeurs inventées. Il ne résout pas toutes les questions de sens. Une citation correcte d’une connexion ne prouve pas que le propriétaire du compte était la personne connectée. Le jugement humain reste nécessaire lorsque la conclusion dépasse le champ observé.
Conservez réponse initiale et rapport corrigé. Expliquez l’évolution d’une conclusion à l’arrivée de nouvelles données. Demandez à un collègue de reproduire le constat le plus important sans lire tout le dialogue. S’il ne trouve pas requête, source ou hypothèse, améliorez les notes. Un rapport utile est une transmission opérationnelle : le suivant sait quoi faire, quoi ne pas supposer et quel résultat modifierait la décision.
Choisir une formation à la réponse aux incidents avec l’IA
Privilégiez une formation qui fait enquêter et agir, pas collectionner des prompts. Le premier écran doit expliquer situation, alerte, systèmes, identités et décision. Les preuves téléchargeables doivent avoir une provenance et des limites. Les exercices doivent proposer des étapes exécutables, des résultats réels à examiner et des contrôles susceptibles d’échouer.
Recherchez une couverture dépassant un fournisseur : identités, postes, systèmes de fichiers, réseau, applications, cloud et systèmes IA. Le cours doit apprendre la prochaine question, pas seulement le prochain menu. Le choix doit être explicite : Claude, Codex/OpenAI OU modèle local autorisé, avec preuves et critères équivalents. Une infrastructure locale peut être un atelier facultatif, pas un obstacle.
La formation de BlueTeam Academy à la réponse aux incidents avec l’IA comprend 49 leçons en anglais, 16 chapitres et 331 diapositives commentées, soit environ quatre heures et 27 minutes de narration, en plus de la pratique. Treize nouveaux cas synthétiques complètent l’enquête Aster/Birch et les ateliers de preuves publiques. Les participants justifient leurs constats, contrôlent l’enrichissement, répètent les mesures et prennent des décisions de rétablissement. Les limites entre simulation et validation en production sont expliquées.
Une équipe peut comparer deux interprétations, reproduire une requête décisive, contester un confinement et expliquer un test de reprise échoué. Un certificat atteste les conditions de réussite du cours, pas une compétence opérationnelle garantie ; il ne remplace pas une pratique accompagnée. Consultez le programme et les exercices, puis choisissez le point de départ adapté aux responsabilités et règles de traitement des preuves de votre équipe.
Réponse avec l’IA : questions pratiques
Que doit enseigner en premier une formation de réponse aux incidents avec l’IA ?
Les types d’incidents, les effets métier et les limites des preuves. Il faut distinguer comportement observé et hypothèse avant de déléguer une analyse. Vient ensuite une boucle : lecture ciblée, résultat réel, vérification et décision d’enquête ou de réponse.
Faut-il Claude, Codex et un modèle sur site ?
Non. Choisissez une voie approuvée. Les mêmes preuves, consignes, requêtes et critères peuvent être utilisés avec Claude, Codex/OpenAI ou un modèle local adapté. Le chat dans un navigateur convient si vous examinez et exécutez les étapes. Installation locale et matériel d’entreprise sont facultatifs.
L’IA peut-elle remplacer les outils forensiques ?
Elle peut aider à utiliser les outils, écrire des parseurs et expliquer les sorties, sans supprimer la nécessité d’une acquisition fiable. Gardez originaux, versions et requêtes reproductibles. Vérifiez que l’interprétation correspond à la sortie réelle, y compris champs absents et lacunes.
Peut-on connecter un agent directement à la production ?
Cela dépend des contrôles approuvés et de la tâche. Commencez par des copies ou un accès de lecture limité. Examinez identité, permissions, outils, destinations et audit. Les actions importantes nécessitent autorisation et vérification séparées. Une consigne ne fait pas respecter seule ces frontières.
Comment vérifier un rapport produit par l’IA ?
Reliez chaque affirmation importante à un enregistrement et à un champ originaux, puis évaluez l’interprétation. Reproduisez les requêtes clés, testez d’autres explications et séparez proposition, exécution et résultat vérifié. Une citation existante ne suffit pas à justifier une conclusion.
Faut-il des logiciels malveillants actifs ou des données privées ?
Non. Le cours fournit des cas synthétiques, des matériaux inertes et des preuves publiques attribuées. Originaux, données normalisées, relectures préparées et réponses simulées sont identifiés. Données d’entreprise, connexions réelles aux modèles et changements de production demandent une autorisation distincte.
Sources et approfondissements
Références officielles des cadres et fonctions cités. Exemples, consignes, diagrammes et méthode de contrôle sont des supports originaux de l’Academy.
- NIST — Incident Response Recommendations, SP 800-61 Rev. 3
- MITRE — Enterprise ATT&CK techniques
- MITRE — Indirect Prompt Injection, T1698
- MITRE ATLAS
- VirusTotal — File report API
- VirusTotal — Public and premium API usage
- Claude Code — Permissions
- Codex — Security
- AWS — CloudTrail data events
Utilisez des données et environnements approuvés. Les exemples fictifs et exercices hors ligne ne prouvent pas les faits d’un incident réel.


