
La risposta breve
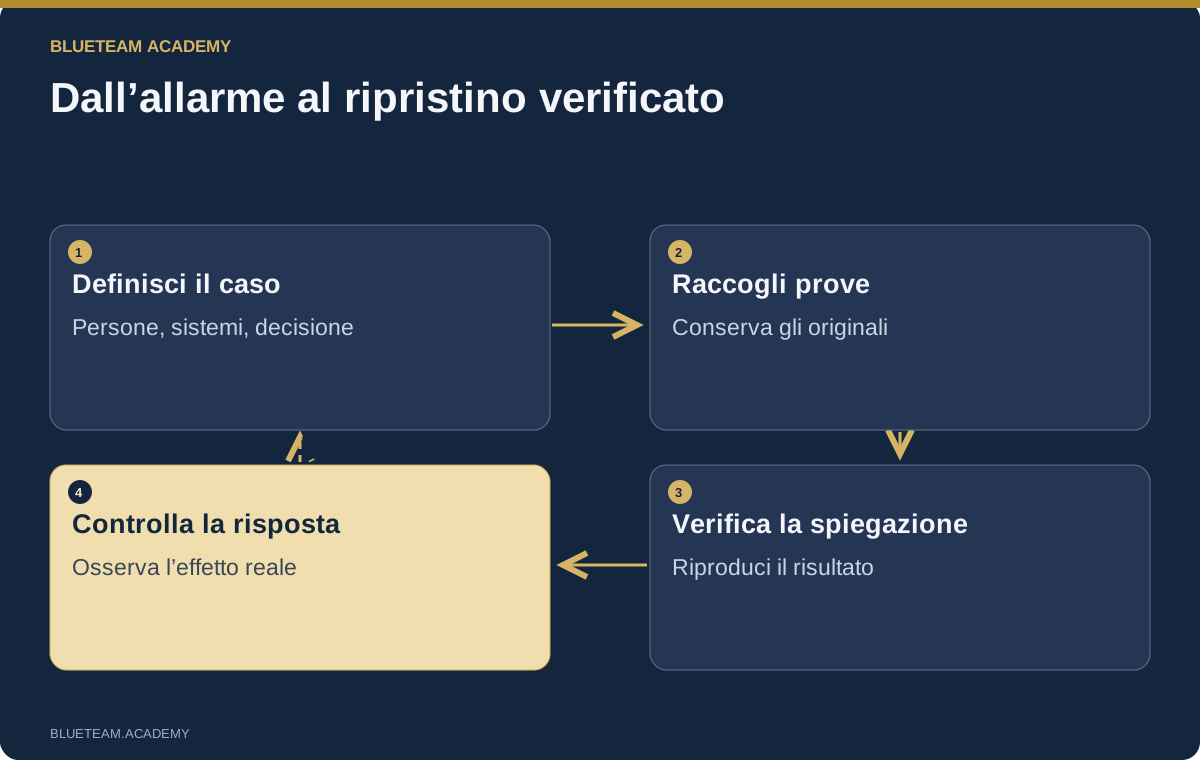
Un corso utile sulla risposta agli incidenti con l’AI insegna a formulare domande investigative, leggere le prove originali, mettere alla prova le conclusioni del modello e verificare le contromisure. Scegli Claude, Codex/OpenAI OPPURE un modello locale approvato. Non servono tutti e tre. Il criterio è sempre lo stesso: un altro analista deve poter riprodurre il risultato e capire perché la risposta è giustificata.
Partire da una storia e da una decisione concreta
Lunedì, ore 9:20. Un addetto ai pagamenti della società immaginaria Riverton riceve una richiesta di modifica delle coordinate bancarie di un fornitore. Il messaggio fa parte di una conversazione abituale. Pochi minuti dopo, il fornitore telefona e nega di averlo inviato. Un avviso di sicurezza segnala anche una regola di posta sconosciuta. L’amministrazione vuole sapere se bloccare il pagamento. Il team che gestisce le identità chiede se disabilitare l’account. Il tuo assistente non ha ancora visto nessuno di questi fatti.
Un’indagine comincia così: una persona, un servizio, un evento osservato e una decisione con conseguenze. «Analizza questa violazione» offre troppo poco contesto. «Usando questi record, stabilisci se la richiesta di pagamento contestata è collegata a un accesso non autorizzato alla posta e indica quali altre prove servono» definisce un incarico preciso. Nel corso di indagine e risposta agli incidenti con l’AI, l’analisi delle prove è collegata a esercizi di contenimento e ripristino.
Scrivi una breve presentazione del caso prima di raccogliere montagne di dati. Indica processo aziendale, account osservato, sistemi, identificativo dell’avviso, intervallo temporale e rischio immediato. Specifica chi può fermare il pagamento o modificare gli accessi. Separa il sospetto dall’osservazione: una regola sconosciuta va verificata, ma non dimostra che un attaccante abbia letto ogni messaggio.
Gli esempi dell’articolo sono situazioni didattiche immaginarie, non rapporti completi di incidenti reali dei clienti. Mostrano come ragionare sulle prove. Il metodo è trasferibile: l’assistente aiuta a organizzare l’indagine; fonti e risultati osservabili stabiliscono ciò che sai davvero.
Riconoscere il tipo di incidente prima di scegliere le prove
Una sessione rubata, un endpoint applicativo esposto, un file server cifrato e una pipeline di build compromessa pongono domande diverse. «Attacco informatico» è una descrizione troppo generica. Parti dal risultato aziendale a rischio. La riservatezza riguarda dati diventati accessibili o usciti dall’organizzazione. L’integrità riguarda modifiche non autorizzate a dati, pagamenti, software o configurazioni. La disponibilità riguarda la capacità del servizio di svolgere il proprio compito. Una sola intrusione può colpire tutte e tre.
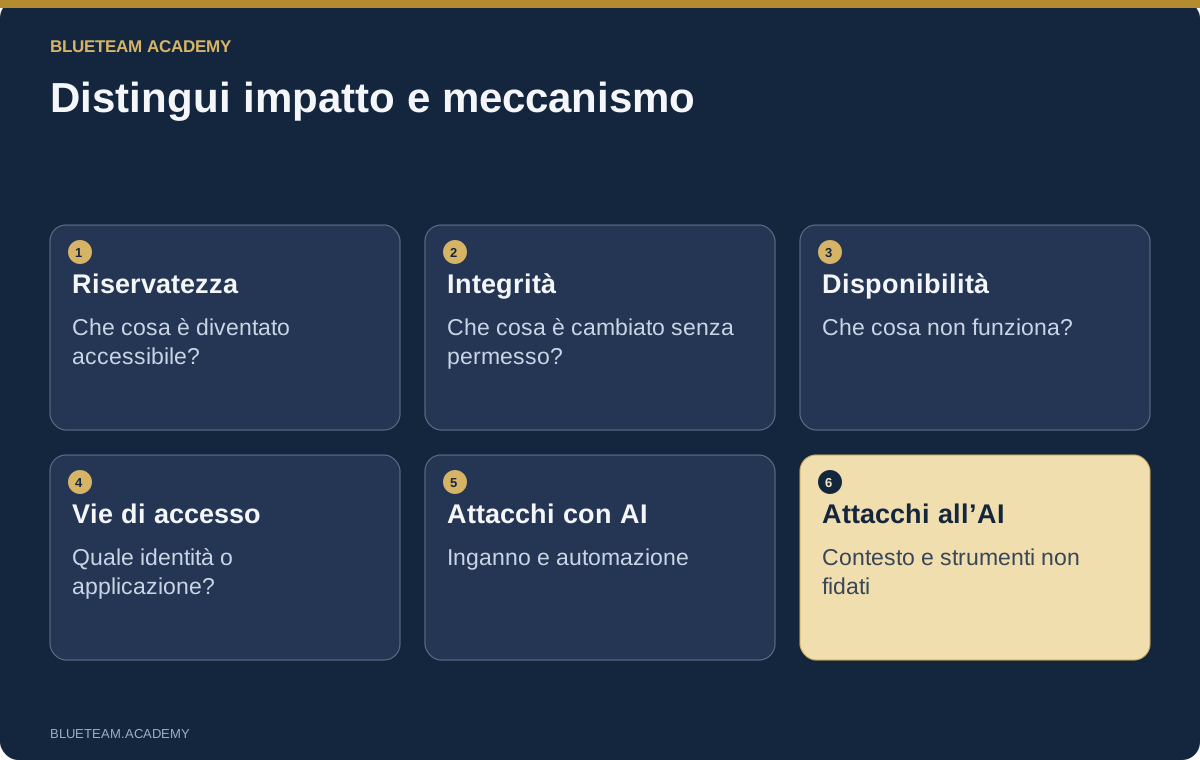
Considera poi i meccanismi plausibili. Una frode via email può usare un mittente falsificato, la vera casella compromessa di un fornitore o una sessione rubata a un dipendente. Un’autorizzazione applicativa può sopravvivere al cambio di password. Un ransomware può rubare dati prima di cifrarli. Su Linux, applicazione web, account di servizio e attività pianificate possono essere collegati. Nel cloud e nei container contano operazioni amministrative, identità dei carichi di lavoro e risorse raggiunte.
Distingui attacchi aiutati dall’AI da attacchi contro sistemi AI. Un aggressore può generare messaggi convincenti o automatizzare compiti senza lasciare una «firma AI» univoca nei log della vittima. Un agente applicativo può invece essere manipolato da documenti non attendibili, contenuti recuperati alterati o permessi eccessivi. Indaga il comportamento osservabile e il controllo che ha ceduto. Non attribuire l’attacco a un modello specifico senza prove.
Chiedi una piccola tabella: tipo possibile, osservazione a sostegno, spiegazione alternativa, prossima fonte decisiva e protezione immediata. Un elenco di tutte le tecniche conosciute non aiuta. Il valore sta nello scegliere la prossima verifica e spiegare come ogni esito cambierebbe la risposta.
Claude, Codex/OpenAI o modello locale: basta una scelta
Il metodo investigativo non dovrebbe richiedere più abbonamenti. Claude, Codex/OpenAI e un modello locale o aziendale approvato possono seguire lo stesso flusso: ricevere una domanda circoscritta, consultare prove consentite, proporre un passo e produrre un risultato da verificare. Capacità e interfacce cambiano; lo standard probatorio resta identico.
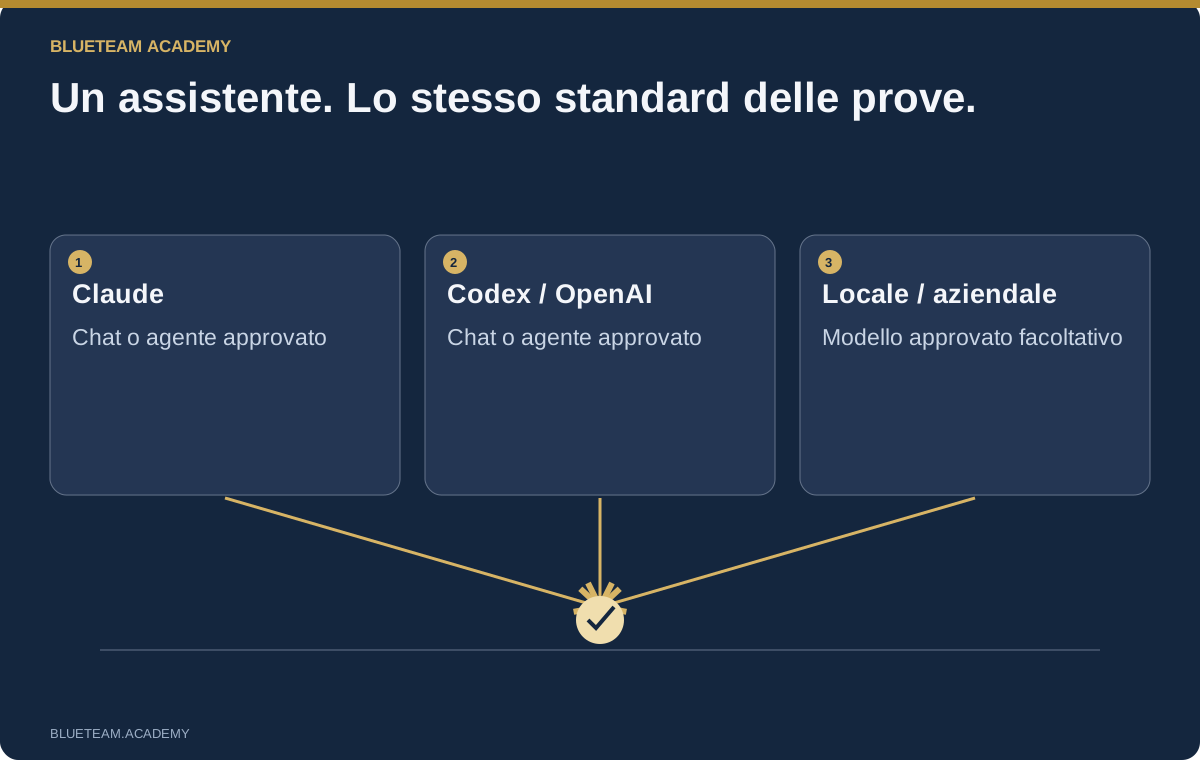
Un assistente nel browser è un punto di partenza valido. Fornisci record sintetici selezionati o estratti autorizzati, chiedi un piano di lettura, esegui tu la query proposta e restituisci il risultato reale. Un agente da terminale può esaminare file e scrivere piccoli parser, ma introduce permessi di esecuzione. Controlla autorizzazioni, servizi collegati e cartelle modificabili prima di aprire il caso. Consulta le indicazioni di sicurezza di Codex o la documentazione dei permessi di Claude Code. Scrivere «sola lettura» nel prompt non crea una sandbox del sistema operativo.
I modelli locali sono facoltativi. Un modello come Qwen3-14B va valutato sui compiti reali: estrazione dei campi, interpretazione degli orari, gestione delle contraddizioni e capacità di non inventare dati mancanti. Il numero di parametri non dimostra la qualità investigativa. Anche un servizio interno richiede autenticazione, separazione dei casi, regole di conservazione e prove di capacità. Un indirizzo locale non prova che ogni elaborazione resti in sede.
Scegli la soluzione autorizzata e registra fornitore, identificativo del modello, data, impostazioni rilevanti e strumenti collegati. Non spostare un caso sensibile su un altro servizio solo perché la prima risposta delude. Migliora la domanda e verifica l’esito prima di cambiare il perimetro di trattamento dei dati.
Organizzare il caso senza consentire la riscrittura degli originali
Conserva gli originali separatamente dai materiali di lavoro. Una struttura utile distingue registri di acquisizione, prove originali, tabelle derivate, query, conversazioni con il modello e azioni di risposta. Un CSV convincente prodotto dall’assistente resta un artefatto derivato, non sostituisce la fonte. Conserva query e regole di trasformazione insieme al risultato.
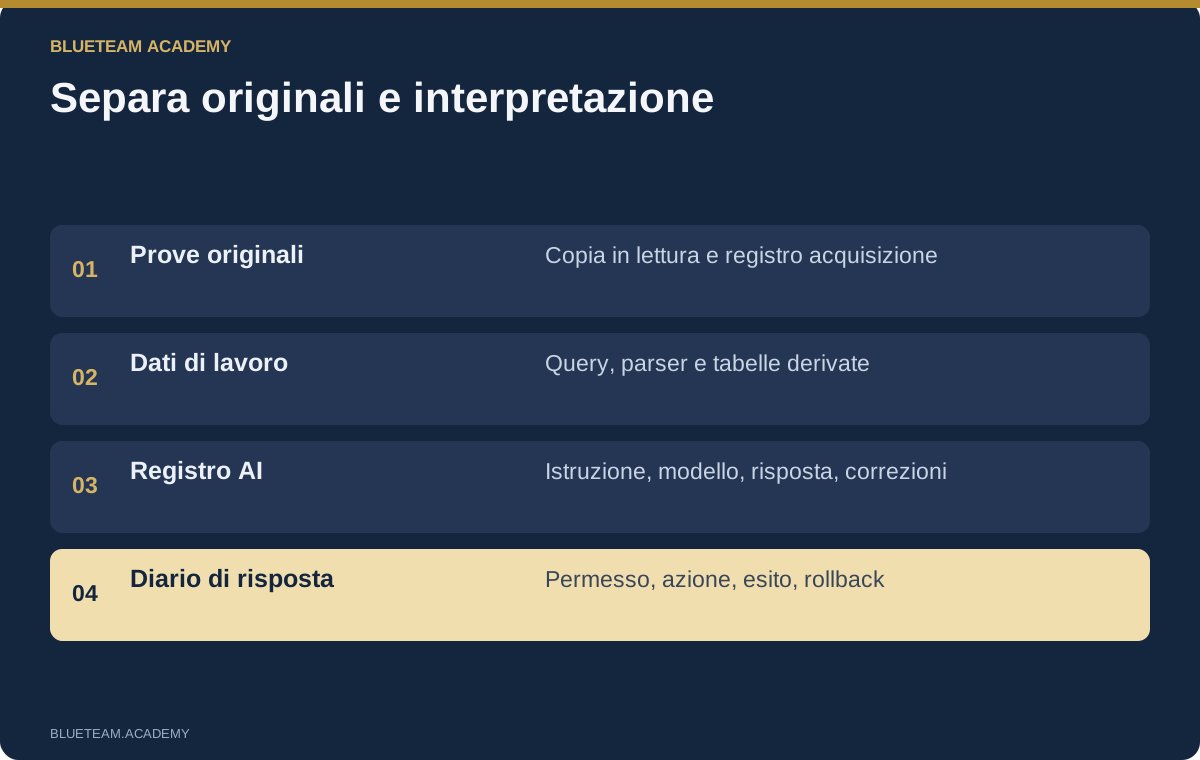
Prepara un registro essenziale delle prove: identificativo stabile, sistema di origine, metodo e momento di raccolta, periodo coperto, fuso orario, filtri e lacune note. Un checksum rileva cambiamenti nei byte, ma non dimostra completezza della raccolta o affidabilità della fonte. Spiega entrambe le cose quando usi un hash a sostegno di una conclusione.
Limita l’assistente a una copia di lavoro. Escludi cartelle di altri clienti, credenziali di produzione, profili del browser e segreti del team. Tratta testi dei log, documenti e nomi di file come input non attendibili: possono contenere istruzioni dell’attaccante. Il modello può leggerle come prova, ma non devono autorizzare strumenti o accessi.
Ogni output deve avere nome e provenienza chiari. Una timeline di processi dovrebbe indicare file di ingresso, versione del parser, query, ipotesi sul fuso e record esclusi. Salva la risposta iniziale prima di editarla. Altrimenti chi revisiona non saprà se un’affermazione proviene da una fonte, dall’analista o dal modello. Note ben organizzate permettono a un collega di proseguire senza ricostruire tutta la conversazione.
Usare un ciclo investigativo ripetibile
Chiedi prima un piano, non un verdetto. L’assistente dovrebbe proporre pochi controlli in sola lettura, indicare la fonte necessaria e spiegare quale alternativa ciascun controllo distingue. Un buon piano include condizioni di arresto. Una domanda circoscritta non richiede automaticamente tutti i log del tenant, tutti gli endpoint e accesso illimitato.
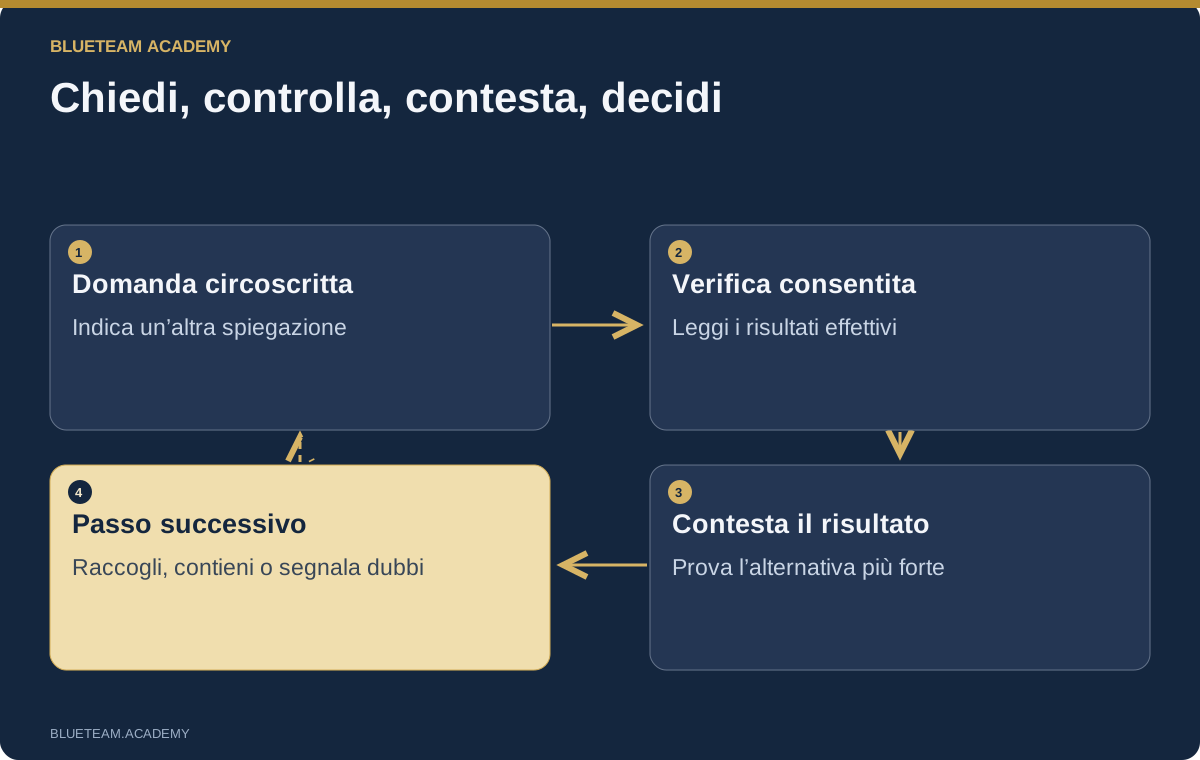
Analizza soltanto i record forniti per questo caso. Proponi prima un massimo di sei controlli in sola lettura. Per ciascuno indica fonte, campi, periodo e spiegazione alternativa. Non eseguire contromisure e non inventare record assenti. Dopo che avrò restituito i risultati, separa osservazioni, deduzioni e incognite. Cita un record e un campo preciso per ogni affermazione importante. Concludi con la domanda la cui risposta potrebbe cambiare maggiormente la reazione.
Rivedi il piano, esegui un controllo consentito ed esamina l’output effettivo. Verifica intervallo, campo di identità e dataset. Restituisci il risultato e chiedi che cosa dimostra e che cosa resta aperto. Conserva query e record, non soltanto il riassunto della conversazione.
Il secondo passaggio deve mettere in discussione il primo. Quale spiegazione innocua è ancora compatibile? Quali prove contraddicono l’ipotesi principale? Quale lacuna potrebbe capovolgere il giudizio? Un secondo modello può aiutare, ma non è obbligatorio. Due risposte basate sulla stessa supposizione non costituiscono verifica indipendente. Riproduci personalmente la correlazione decisiva.
Chiudi ogni ciclo con una decisione: acquisire un’altra fonte, applicare una misura autorizzata, restringere l’ambito o comunicare un’incertezza specifica. Così il prompting diventa lavoro investigativo. Senza una decisione, anche una risposta impeccabile nella forma può restare un documento che nessuno usa durante l’incidente.
Indagare frodi email, sessioni rubate e accessi applicativi
Torniamo al pagamento contestato di Riverton. Raccogli identificativi dei messaggi, instradamento, risultati di autenticazione, regola di posta, audit e versione del fornitore. Il superamento di SPF, DKIM o DMARC risponde a domande sull’autenticazione della posta, non sulla legittimità dell’ordine di pagamento. L’account reale del mittente può essere compromesso o una conversazione autentica abusata.
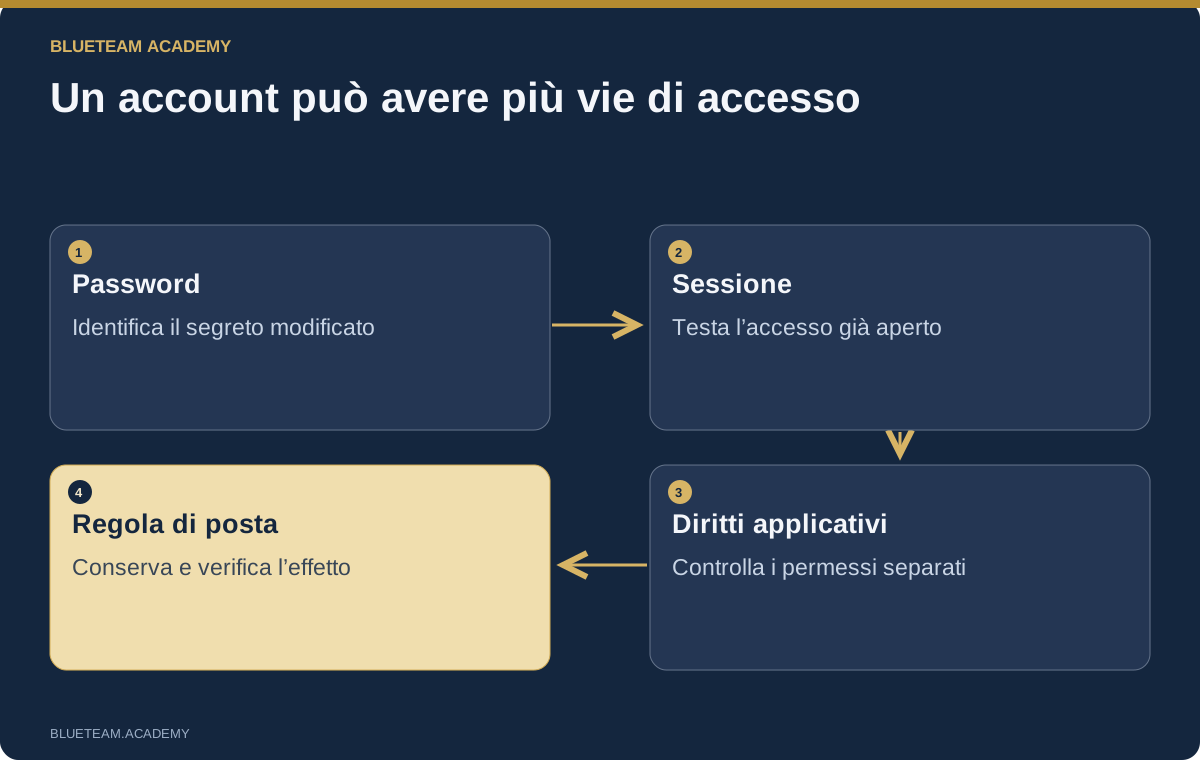
Chiedi di correlare l’operazione sulla regola con account, applicazione o sessione pertinenti. Controlla quale fonte identifica l’attore e se descrive un accesso umano, un’azione amministrativa o un’applicazione. Confronta gli orari con attenzione. Un IP condiviso o un dispositivo familiare offre contesto, senza dimostrare quale persona abbia operato.
Separa i percorsi di accesso prima di reagire. Cambio password, invalidazione delle sessioni, rimozione di inoltri e revoca di autorizzazioni applicative risolvono meccanismi diversi. Non dichiarare l’account sicuro perché un solo comando ha avuto successo. Preserva le prove, chiarisci chi approva ogni modifica e verifica se il percorso sospetto funziona ancora. In un esercizio, una contromisura inefficace deve essere osservabile, non nascosta nel foglio delle risposte.
Con Microsoft 365, Google Workspace o altre piattaforme, chiedi sempre: quale identità ha agito, con quale sessione o applicazione, su quale risorsa, con quali diritti e quale effetto? Le interfacce cambiano, il ragionamento si trasferisce. Mantieni nel piano anche sospensione del pagamento e verifica indipendente del fornitore. Un intervento tecnico riuscito non recupera denaro e non convalida nuove coordinate bancarie.
Analizzare un file sospetto senza inventare comportamenti
Un eseguibile sospetto offre tipi diversi di prova. L’analisi statica descrive struttura, import, sezioni, stringhe e firma. I record dell’endpoint descrivono attività osservata su un host preciso. Una sandbox descrive un’esecuzione nelle proprie condizioni. I servizi di reputazione aggiungono osservazioni raccolte altrove. Non lasciare che una categoria sostituisca silenziosamente l’altra.
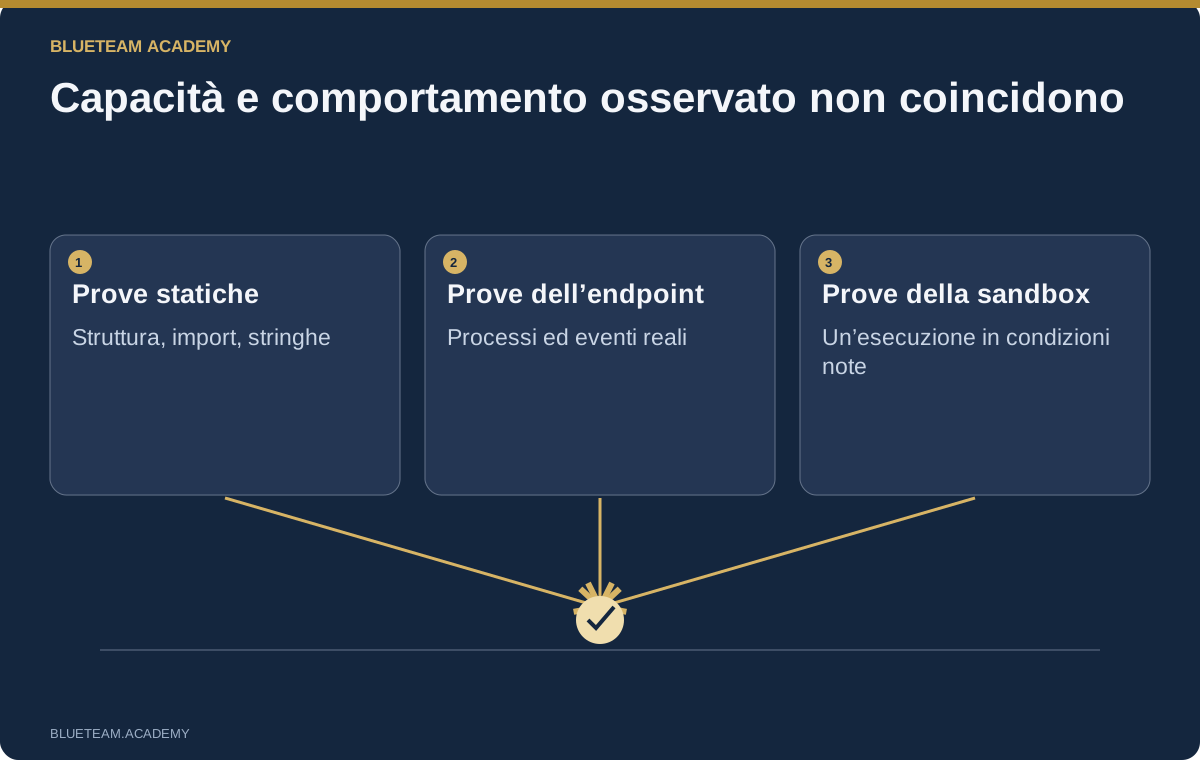
Supponi che un file importi una funzione di rete e che un evento mostri un processo PowerShell figlio. Non dimostra furto di credenziali, cifratura o contatto con ogni dominio nelle stringhe. Chiedi di separare capacità, comportamento osservato e ipotesi. Per affermare un’esecuzione servono relazione esatta tra processi e fonte. Una riga di comando mancante deve rimanere tale, senza essere completata con un attacco familiare.
Usa strumenti approvati per ottenere output circoscritti che il modello possa spiegare. PEStudio, un analizzatore di capacità o un disassemblatore rispondono a domande differenti. Conserva output originale e versione. Se viene proposta la decodifica di una stringa, controlla l’operazione e mantieni il risultato come dato. Non eseguire comandi estratti soltanto per provarli.
Gli esercizi possono usare artefatti inerti, sintesi di sandbox preparate e prove pubbliche selezionate con provenienza chiara. Un compito utile chiede di calcolare l’hash reale del campione, distinguerlo da un identificativo illustrativo e indicare le prove ancora necessarie. Anche le regole di rilevamento vanno testate: una regola YARA basata sul nome di un’API comune può produrre molti falsi positivi. Chiedi campioni positivi e innocui e verifica i risultati prima dell’eventuale uso operativo.
Correlare log, MFT e identità dei processi
L’AI può spiegare uno schema di log, scrivere un parser o trovare una sequenza candidata. Non sostituisce il contesto quando riceve esportazioni prive di descrizione e deve ricostruire un’intera intrusione. Parti da formato e copertura. Una tabella normalizzata è più leggibile, ma può omettere campi necessari per distinguere eventi. Conserva un percorso verso gli originali.
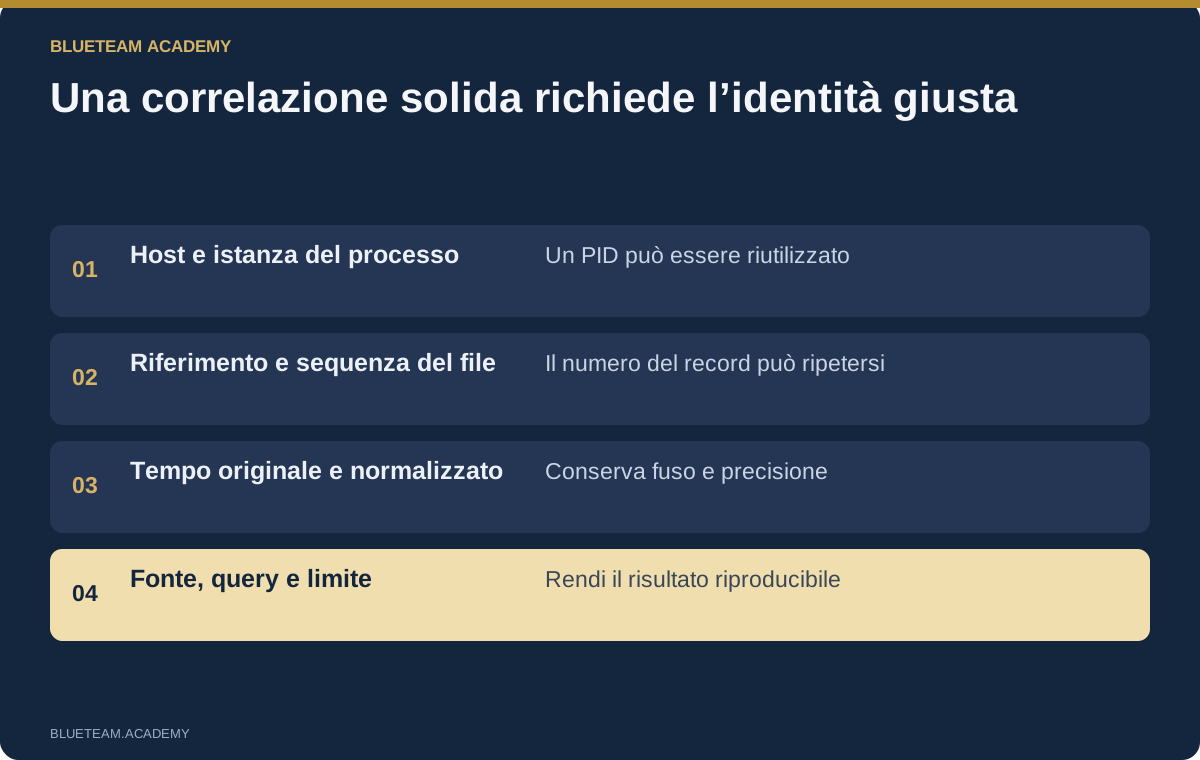
In Windows distingui PID e identificativo dell’istanza del processo, includendo host e intervallo nelle join. I PID possono essere riutilizzati. Una relazione padre-figlio richiede campi adeguati: nomi simili e tempi vicini non provano discendenza. Per il filesystem, comprendi riferimento del record e numero di sequenza prima di unire corrispondenze. Un record MFT riutilizzato non identifica automaticamente lo stesso file.
Verifica separatamente gli orari. Tempo dell’evento, della raccolta, del filesystem e ora locale visualizzata possono rispondere a domande diverse. Fai dichiarare timestamp usato, gestione di fusi, precisione e differenze tra orologi. Conserva valore originale e normalizzato insieme. Non ordinare gli eventi con precisione superiore a quella disponibile.
Assegna un compito concreto: individuare candidati, mostrare chiavi di join, elencare righe senza corrispondenza e spiegare un controesempio. Prova la query con un positivo noto e un valore volutamente assente. Zero risultati significa soltanto che nulla è stato trovato nel dataset raccolto. Non dimostra che nulla sia accaduto su un endpoint non monitorato. Limiti espliciti rendono l’indagine più solida.
Verificare l’esfiltrazione con le prove di rete
Una connessione in uscita è una pista, non una conclusione completa di esfiltrazione. Stabilisci sorgente, destinazione, protocollo, orario, processo se disponibile e punto di osservazione. Firewall, proxy e cattura pacchetti possono descrivere aspetti diversi della stessa attività. Spiega che cosa misura ciascuno prima di combinare i numeri.
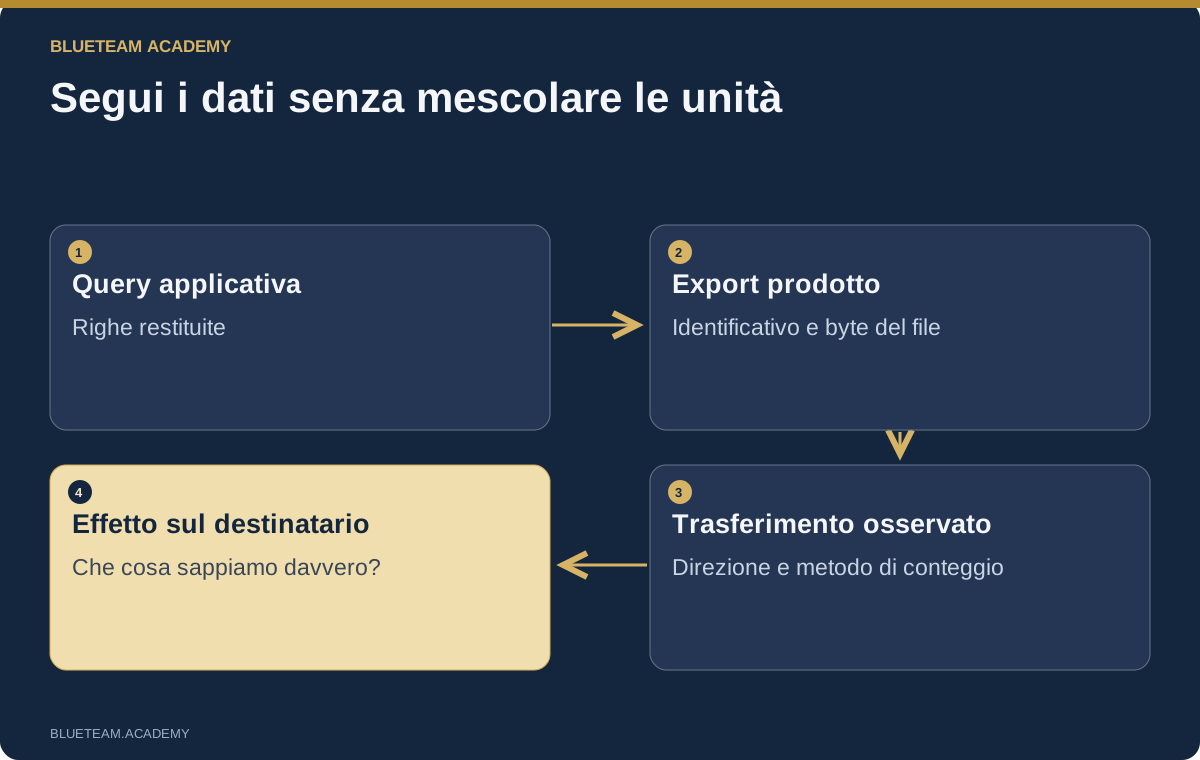
Il conteggio dei byte è insidioso. Una cattura può includere ritrasmissioni, mentre un proxy conta a livello applicativo. TLS può nascondere il contenuto pur lasciando visibili i metadati. La dimensione di una risposta non è il numero di record cliente unici. Chiedi unità, direzione, fonte e metodo di aggregazione per ogni quantità.
Un caso più forte collega query applicativa, export prodotto, identificativo o hash del file, consegna e osservazione di rete. Se un alert contiene l’hash di un archivio, verifica che sia lo stesso artefatto e non un nome simile. Indica quali collegamenti sono dimostrati e quali ipotetici. Una richiesta di upload non prova sempre che il destinatario abbia conservato o letto il contenuto.
Un prompt utile è: «Mostra il percorso supportato dai dati sorgente al trasferimento esterno. Per ogni collegamento cita il record originale e il test mancante». Poi chiedi un’altra spiegazione compatibile con il traffico. Bloccare una destinazione, sospendere un export o cambiare accessi richiede un responsabile e una verifica dell’effetto. Bloccare un IP condiviso può interrompere traffico legittimo e lasciare aperta un’altra uscita.
Usare ATT&CK per ragionare sulle prove
MITRE ATT&CK offre un linguaggio per i comportamenti degli avversari. Usalo per organizzare osservazioni, individuare fonti necessarie e comunicare l’ambito. Un’etichetta del prodotto non deve diventare una catena di tecniche confermata. Il modello deve spiegare il comportamento dietro ogni associazione e citare la prova.
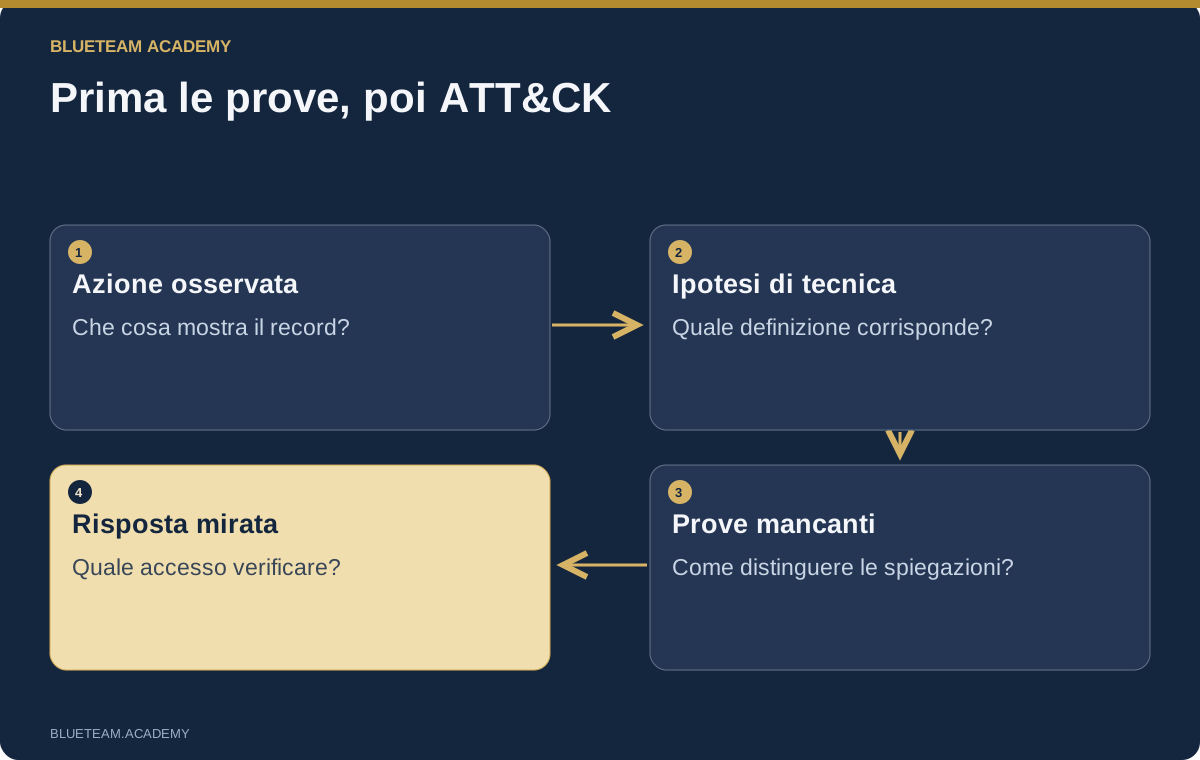
Un accesso di rete, un controllo consentito su una condivisione amministrativa, un nuovo servizio e un processo avviato dal gestore dei servizi possono sostenere un’indagine sul movimento laterale. Non provano da soli credential dumping o come sia stato ottenuto il segreto dell’account. Chiedi tecnica, comportamento, identificativi delle fonti, grado di fiducia e prossimo test. I candidati senza prove restano ipotesi.
Consulta le definizioni correnti di Enterprise ATT&CK. Nomi e framework evolvono. Per sistemi AI, voci come Indirect Prompt Injection e MITRE ATLAS forniscono contesto. Un identificativo ricordato dal modello non è una fonte autorevole.
Il vantaggio pratico è un piano migliore. Se ipotizzi esecuzione remota di servizi, individua i record che la distinguono dall’amministrazione autorizzata. Se ipotizzi accesso applicativo, esamina autorizzazione e operazioni sulle risorse. Il diagramma deve mostrare lacune e domande. Colorare più caselle non completa l’indagine e non spiega da solo l’impatto sull’azienda.
Indagare server Linux e autorizzazioni API difettose
Un incidente web attraversa reverse proxy, applicazione, sistema operativo e rete. Correla identificativi delle richieste, relazioni dei worker, percorsi e genealogia dei processi, quando disponibili. Una shell dopo un caricamento merita attenzione, ma la vicinanza temporale non dimostra il collegamento richiesta-processo.
Esamina insieme prove applicative e host. È stato ammesso un tipo di file vietato? Il percorso permetteva esecuzione? Quale identità eseguiva il worker? Esistono attività pianificate, modifiche ai servizi o connessioni correlate? Raggruppa i record Linux audit divisi tramite l’identificativo comune dell’evento e preserva i campi. Un file di proprietà root non identifica la persona che lo ha creato.
Un incidente API può richiedere una risposta diversa dalla compromissione dell’host. Un utente legittimo può chiedere l’oggetto di un’altra azienda se il server non ne controlla la proprietà. Confronta identità autenticata, tenant risolto sul server, oggetto e decisione di autorizzazione. Il tenant fornito da client o modello non è una fonte fidata di diritti.
Chiedi all’AI percorsi correlati e test negativi: export sincroni, job in background, download, cache e operazioni massive. Rivedi il codice ed esegui test rappresentativi in ambiente autorizzato. Una funzione corretta non prova che tutti i percorsi siano protetti. Delimita l’esposizione storica con richieste e consegne conservate, dichiarando i vuoti. Per ripristinare servono sia una barriera corretta sia accessi legittimi funzionanti.
Seguire identità e controller nel cloud e nei container
Distingui operazioni di gestione e accesso ai dati. Una modifica ai permessi, creazione di chiavi o cambio della raccolta log può spiegare come l’accesso sia diventato possibile. Per sapere che cosa è stato letto o cambiato servono eventi sulle risorse, se raccolti. Controlla la configurazione prima di interpretare un export vuoto. La documentazione dei data event CloudTrail chiarisce l’importanza della copertura.
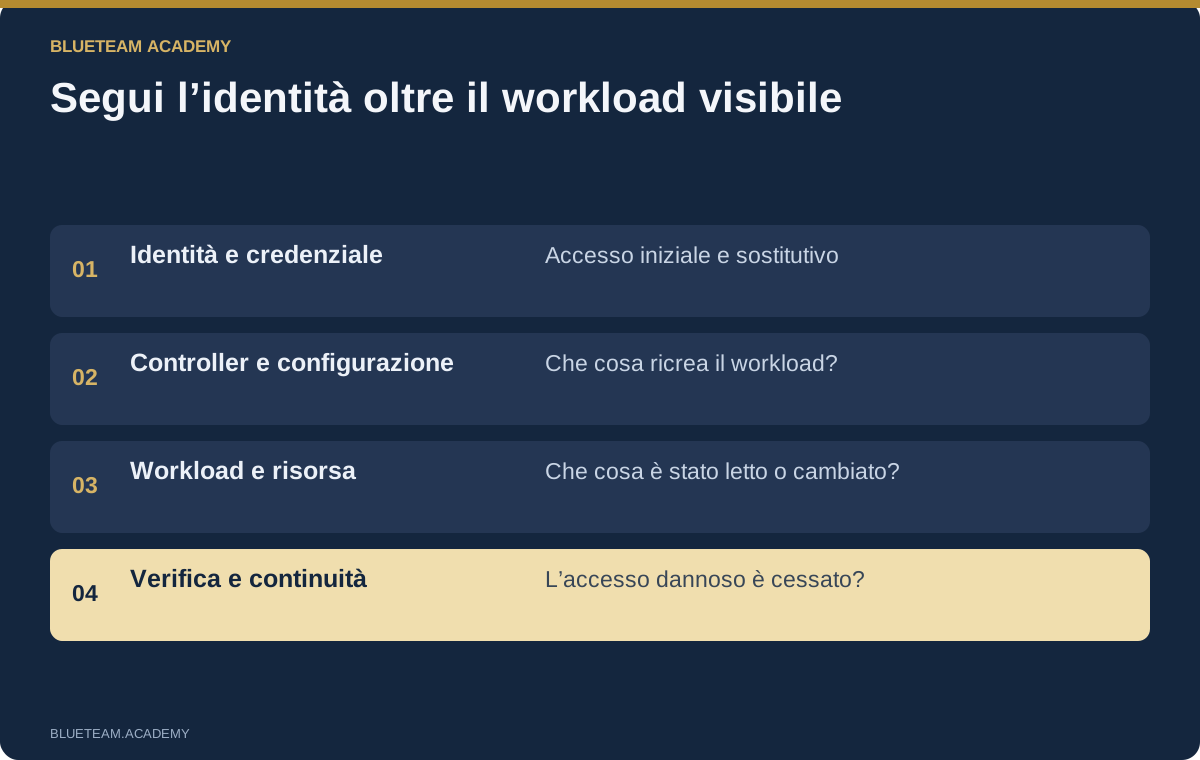
Ragiona per vie di accesso. Se una credenziale esposta ne crea un’altra, revocare soltanto la prima può non bastare. Chiedi un grafo di identità, credenziali, concessioni, operazioni e cambi successivi. Ogni arco deve avere prove o essere dichiarato ipotesi. Conserva identificativi, tempi di emissione e risorse per distinguere operazione eseguita e tentativo negato.
Per i container includi controller e contesto del nodo. Eliminare un pod sospetto può semplicemente farlo ricreare. Esamina service account, ammissione, digest dell’immagine, contesto di sicurezza, mount dell’host e dati del nodo. Una richiesta riuscita di elenco dei secret va interpretata secondo i dettagli registrati: il log potrebbe non contenere i valori restituiti.
Il piano di contenimento deve coprire identità, controller, workload e credenziali esposte. Mantieni le azioni distruttive fuori dagli strumenti di analisi. Prova l’effetto in staging o in un processo approvato, verificando ricomparsa del workload e funzioni legittime. L’AI aziendale è soggetta agli stessi rischi infrastrutturali: la posizione fisica non elimina la necessità di controllare identità e configurazioni.
Distinguere ransomware e guasti ordinari
Cifratura e distruzione impongono urgenza, ma non rendono ogni sintomo diagnostico. Stabilisci quali sistemi cambiano in modo anomalo, processo o identità coinvolti, prosecuzione dell’attività e servizi dipendenti. Preserva prove volatili quando è possibile senza prolungare danni evitabili. Il responsabile della risposta deve rendere esplicito questo compromesso.
Confronta attività sospette e manutenzione autorizzata. Un account di deployment può essere legittimo, ma non il suo uso su un file server estraneo. Un dashboard di backup verde non dimostra un ripristino riuscito. Il successo di un comando non prova che l’obiettivo del servizio sia raggiunto. Inserisci un test che misuri il risultato operativo.
Versioni difettose, pool di connessioni esauriti ed errori di configurazione causano indisponibilità. Un picco di richieste può essere attacco, domanda legittima o effetto secondario. Confronta metriche, cronologia delle modifiche, errori e rete. Se un rollback risolve il problema, documentalo senza dichiarare automaticamente esclusa un’azione malevola.
Il piano comprende contenimento, continuità, prove, origine affidabile del ripristino, accettazione e soglia di rollback. Che cosa succede se il primo restore fallisce o la riconnessione riapre la stessa debolezza? Un esercizio utile fa affrontare il fallimento. «Esistono backup» descrive la preparazione; «il ripristino testato soddisfa questi controlli tecnici e aziendali» è un risultato verificato.
Indagare la supply chain e gli attacchi alle applicazioni AI
Le indagini sulla supply chain collegano provenienza del software ed esposizione di credenziali. Confronta sorgente approvata, risoluzione delle dipendenze, ambiente di build, artefatto e digest distribuito. Un tag noto o una firma valida non prova da solo il contenuto atteso. Verifica che cosa lega la firma o attestazione, chi controllava l’identità e se gli input corrispondono alla release.
Fornisci cambi ai lockfile, log di build e inventari per un confronto limitato. Non rieseguire build sconosciute su una workstation privilegiata solo per riprodurre il caso. Identifica i segreti disponibili al runner e le operazioni realmente svolte. Segui l’artefatto tramite digest nella distribuzione. Una ricostruzione pulita può avere hash diverso: la riproducibilità dipende dal processo e dalle prove.
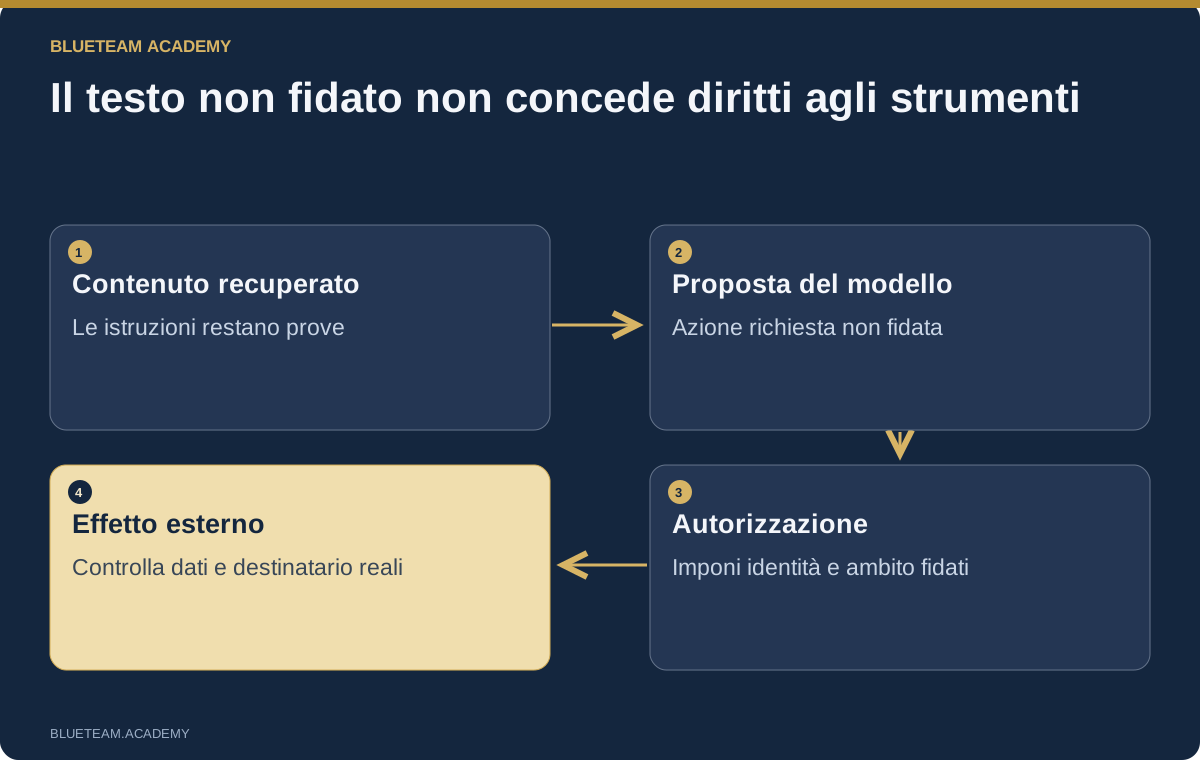
Per un’applicazione AI esiste un’altra catena: input non fidato, proposta del modello, autorizzazione dello strumento ed effetto esterno. Un’istruzione malevola in un ticket recuperato può influenzare il modello senza cambiare l’identità fidata. Verifica che il dispatcher degli strumenti la imponga autonomamente. Distingui una lettura tra aziende negata da un invio esterno consentito.
Analizza il testo sospetto in un contesto separato, senza gli strumenti privilegiati originali. Esamina provenienza dei contenuti, argomenti, log di autorizzazione, destinazioni e dati realmente restituiti o trasmessi. Prova il caso negativo: il testo resta leggibile come dato ma non autorizza letture estranee o trasferimenti. Correggi il controllo fallito e verifica. Dire al modello di ignorare istruzioni cattive non dimostra la sicurezza dell’applicazione.
Collegare VirusTotal senza pubblicare il caso
La reputazione aiuta a stabilire priorità, ma non è un verdetto sull’incidente. Parti da un hash noto e una politica approvata di condivisione. La ricerca esatta richiede un rapporto esistente, invece di caricare il file. Rivela comunque a un servizio esterno ciò che stai cercando: non è invisibile né automaticamente ammessa.
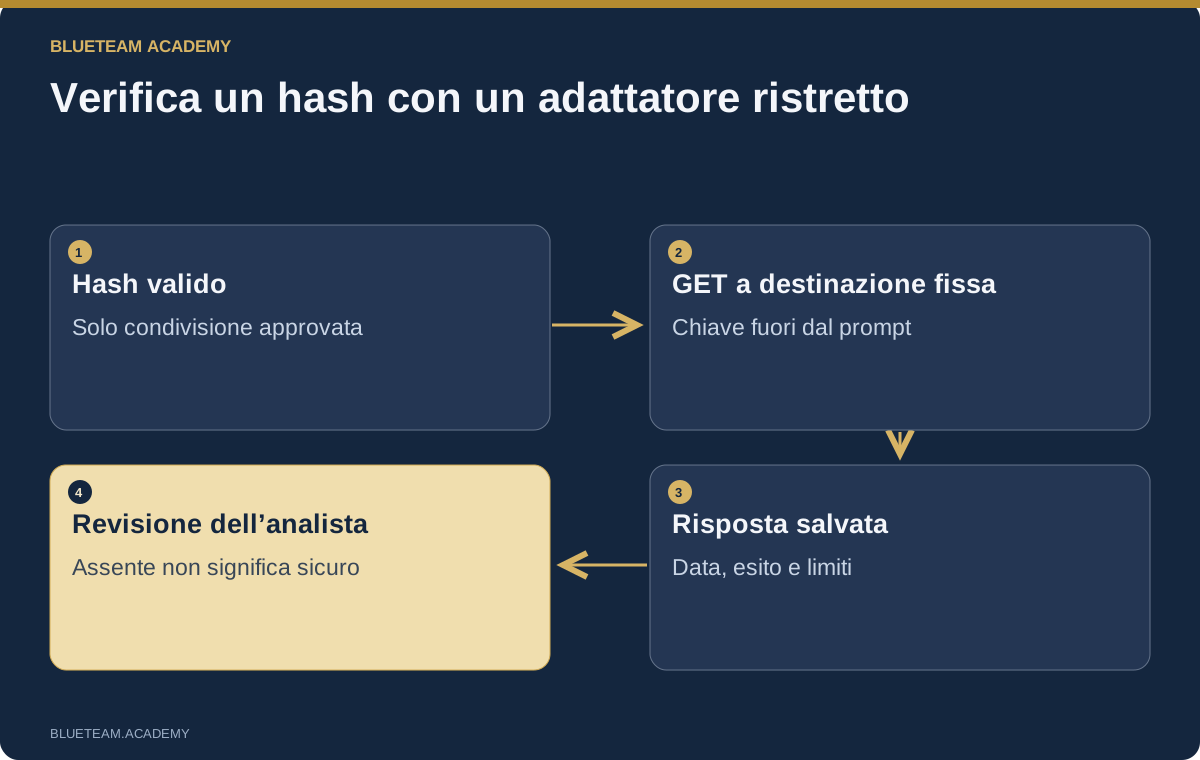
L’endpoint VirusTotal dei rapporti file restituisce informazioni per identificativo. Un adattatore ristretto può accettare solo SHA-256 validi, usare una destinazione fissa, leggere la chiave da una variabile protetta, rifiutare redirect e imporre timeout. Il testo delle prove non deve fornire l’URL, né la chiave finire nel prompt. Verifica i diritti commerciali secondo le condizioni API di VirusTotal.
Fai interpretare una risposta salvata con orario della raccolta, data del rapporto e risultati. L’assenza di un rapporto non equivale a un file sicuro. Il limite di richieste deve fermare o rinviare il lookup, non avviare rotazioni di chiavi o tentativi infiniti. Le rilevazioni dei vendor sono osservazioni: dividerle per il numero dei motori non produce una probabilità calibrata di attacco.
Non caricare documenti riservati, dump di memoria, esportazioni email o file dei clienti in un normale flusso pubblico «per provare». Possono contenere dati personali, segreti e proprietà aziendali. Se necessario, usa analisi privata approvata. La formazione può usare risposte registrate per successo, assenza e rate limit, offrendo un lookup reale facoltativo con account autorizzato.
Preparare la risposta con l’AI e verificarne l’effetto
Un’indagine che finisce con un bel rapporto può lasciare attivo l’accesso dannoso. Ogni risultato importante deve portare a domande operative: che cosa cambiare, chi autorizza, quali prove preservare, quale funzione rischia interruzioni e come capire se l’intervento ha funzionato? L’assistente struttura il ragionamento, non diventa l’autorità che approva.
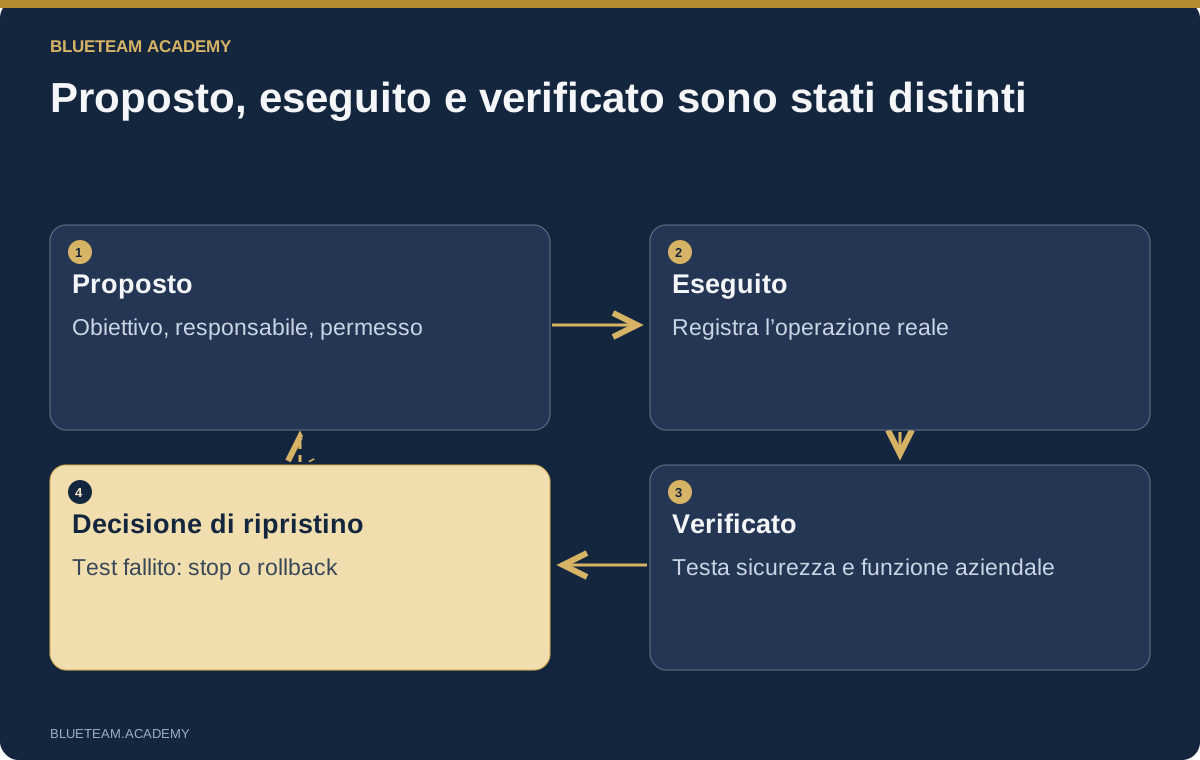
Separa proposto, eseguito e verificato. «Disabilitare la chiave» è una proposta. Un audit dell’operazione prova l’esecuzione. Un test controllato che rifiuta la vecchia chiave, insieme alla ricerca di credenziali sostitutive, contribuisce alla verifica. Non comprimere questi stati in un segno verde. Vale per regole email, autorizzazioni applicative, isolamento host e rollback.
Tieni un diario con ID dell’azione, obiettivo, fondamento, responsabile, approvatore, effetto previsto, riferimento di esecuzione, esito del test e condizione di ritorno. Aggiungi tempi e dipendenze. Se isolare un host interrompe pagamenti critici, registra continuità e decisore. Se il ritardo aumenta il danno, motiva l’urgenza e le eventuali prove perse.
Il ripristino richiede criteri indipendenti. Testa accesso originario non autorizzato, persistenza e alternative, controllo riparato e funzione aziendale. Definisci rientro limitato e condizione di stop o annullamento. Un test fallito deve produrre un no-go, non un rapporto riscritto con maggiore sicurezza.
NIST SP 800-61 Rev. 3 inserisce la risposta nella gestione del rischio cyber. Trasforma le lezioni in miglioramenti assegnati: lacune dei log, ruoli confusi, test deboli e diritti eccessivi degli agenti. Il caso non finisce soltanto perché l’avviso visibile smette di comparire.
Controllare prove e interpretazione nei rapporti AI
Chiedi risultati diversi per lettori diversi. Il passaggio tecnico richiede identificativi, query, collegamenti delle fonti, incertezze, azioni e verifiche residue. La direzione vuole impatto aziendale, ciò che è controllato, ciò che resta incerto, decisione e prossimo aggiornamento. Entrambi devono descrivere lo stesso stato. Un riassunto breve non può essere più certo delle prove tecniche.
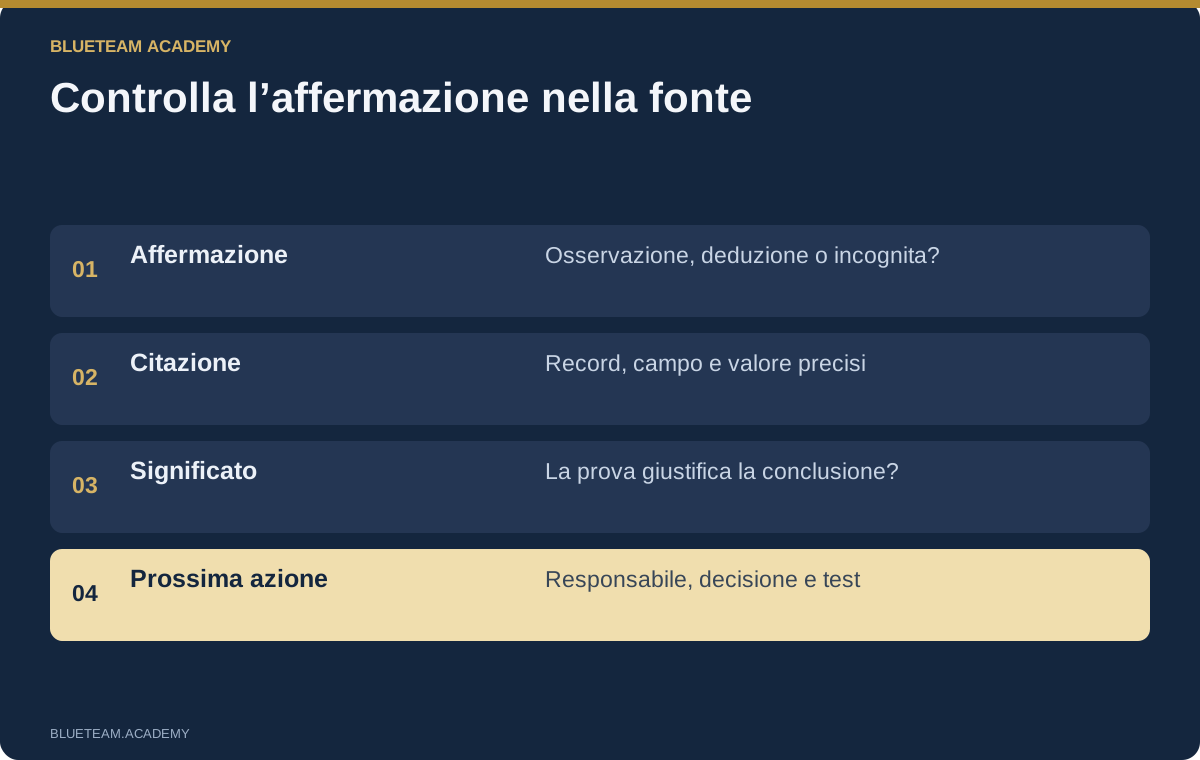
Verifica ogni frase rilevante. Il record citato è apribile? Il campo contiene il valore? Il valore sostiene l’interpretazione? La fonte appartiene a un altro caso? Un’azione proposta è descritta come completata? «Nessun evento in questo export» è diventato «nessuna compromissione»? Sono controlli di sostanza, non grammaticali.
Usa un registro delle affermazioni: osservazione o deduzione, fonte, campo esatto, limite e prossimo controllo. Un validatore automatico può respingere ID mancanti o valori inventati, ma non decide ogni questione di significato. Una citazione corretta a un login non prova che fosse il proprietario dell’account a usarlo. Serve giudizio umano quando la conclusione supera il dato osservato.
Salva risposta iniziale e rapporto corretto. Spiega perché una conclusione cambia con nuove prove. Chiedi a un collega di riprodurre il risultato più importante senza leggere tutta la chat. Se non trova query, fonte o ipotesi, migliora le note. Un rapporto utile è un passaggio operativo: indica cosa fare, cosa non presumere e quale risultato cambierebbe la decisione.
Che cosa cercare in un corso di risposta agli incidenti con AI
Scegli formazione che faccia indagare e rispondere, non collezionare prompt. La prima schermata deve spiegare storia, alert, sistemi, identità e decisione. Le prove scaricabili devono avere provenienza e limiti. Gli esercizi devono offrire passi eseguibili, risultati effettivi da ispezionare e controlli che possano fallire.
Cerca copertura oltre un solo vendor: identità, endpoint, filesystem, rete, applicazioni, cloud e sistemi AI. Bisogna imparare la domanda successiva, non soltanto il menu. La scelta è Claude, Codex/OpenAI OPPURE modello locale approvato, con prove e criteri equivalenti. L’infrastruttura locale può essere un laboratorio opzionale, non una barriera.
Il corso BlueTeam Academy di risposta agli incidenti con AI contiene 49 lezioni in inglese, 16 capitoli e 331 slide narrate: circa quattro ore e 27 minuti di audio oltre alla pratica. Tredici nuovi casi sintetici affiancano l’indagine Aster/Birch e i laboratori con prove pubbliche. Si lavora su risultati collegati alle fonti, arricchimento controllato, prove di risposta e decisioni di ripristino. Sono espliciti i confini tra simulazione e validazione in produzione.
I team possono confrontare interpretazioni, riprodurre una query, contestare il contenimento e spiegare un test di recupero fallito. Il certificato attesta i requisiti di completamento, non garantisce competenza operativa e non sostituisce la pratica supervisionata. Consulta programma ed esercizi, quindi scegli il punto di partenza in base a responsabilità e regole di gestione delle prove.
Risposta con AI: domande pratiche
Da dove deve iniziare un corso di risposta agli incidenti con AI?
Da tipi di incidente, impatto aziendale e limiti delle prove. Occorre distinguere comportamento osservato e ipotesi. Poi si introduce il ciclo: lettura circoscritta, risultato reale, verifica e decisione sul prossimo passo investigativo o di risposta.
Servono Claude, Codex e un modello on-prem?
No. Basta una soluzione approvata. Prove, prompt, query e criteri si possono usare con Claude, Codex/OpenAI o un modello locale adatto. È possibile anche il browser, verificando ed eseguendo personalmente i passi. Installazione locale e hardware aziendale sono facoltativi.
L’AI sostituisce gli strumenti forensi?
Può aiutare a usarli, scrivere parser e spiegare risultati, ma restano necessarie acquisizione e analisi affidabili. Conserva originali, versioni e query riproducibili. Verifica la corrispondenza tra interpretazione e output reale, incluse assenze e lacune.
È sicuro collegare direttamente un agente alla produzione?
Dipende da controlli approvati e compito. Parti da copie o lettura strettamente limitata. Verifica identità, permessi, strumenti, destinazioni e audit. Le azioni rilevanti richiedono autorizzazione e verifica separate. Un prompt da solo non impone tali limiti.
Come controllare l’accuratezza di un rapporto AI?
Collega ogni affermazione importante al record e campo originali, poi valuta se la conclusione segue. Riproduci le query, prova spiegazioni alternative e separa proposta, esecuzione e verifica. Una citazione esistente non rende automaticamente giusto il ragionamento.
Sono necessari malware attivo e dati riservati?
No. Il corso offre casi sintetici, materiali inerti e prove pubbliche attribuite. Originali, record normalizzati, riproduzioni preparate e risposte simulate sono identificati. Dati aziendali, collegamenti reali ai modelli e modifiche alla produzione richiedono autorizzazione separata.
Fonti e letture di approfondimento
Fonti ufficiali per i framework e le funzioni citati. Esempi, istruzioni, diagrammi e metodo di verifica sono materiali originali dell’Academy.
- NIST — Incident Response Recommendations, SP 800-61 Rev. 3
- MITRE — Enterprise ATT&CK techniques
- MITRE — Indirect Prompt Injection, T1698
- MITRE ATLAS
- VirusTotal — File report API
- VirusTotal — Public and premium API usage
- Claude Code — Permissions
- Codex — Security
- AWS — CloudTrail data events
Usa dati e ambienti approvati. Esempi immaginari ed esercizi offline non dimostrano i fatti di un incidente reale.


